« Placebo – Enquête historique et scientifique sur un mystère médical » de Richard Monvoisin, Léo Druart et Nicolas Pinsault (Note de lecture)


Avec Placebo, Enquête historique et scientifique sur un mystère médical, Richard Monvoisin, Léo Druart et Nicolas Pinsault nous livrent une synthèse massive de tout ce que l’on sait, aujourd’hui, sur ce fameux « effet placebo ». L’ouvrage débute avec un panorama historique de la notion de placebo ; il met ensuite en évidence la place fondamentale qu’il occupe dans les méthodes contemporaines de la médecine et de la pharmacologie scientifiques ; un gros chapitre est alors consacré à ce qu’est l’effet placebo et aux mécanismes sous-jacents qui expliquent cet effet ; vient ensuite le tour de son double maléfique, l’effet nocebo, qui relève de mécanismes assez similaires ; enfin, le dernier chapitre explore certaines questions éthiques et politiques associés au placebo dans le soin contemporain. Ce compte-rendu a pour objectif de donner un avant goût de l’ouvrage, avec quelques éléments choisis de chaque chapitre, juste assez pour vous donner l’envie de le lire !

Chapitre 1 : De quoi placebo est-il le nom ? (p. 19)

L’ouvrage débute avec une histoire très fournie de la notion de placebo, en commençant par l’origine même du mot. Tout est parti d’un choix de traduction du premier verset d’un psaume de la Bible que le futur Saint Jérôme, au 4ème siècle, traduit en latin. Il remplace « ambulabo » (je marcherai) par « placebo » (je plairai) – Dieu seul sait pourquoi. En tout cas, des siècles plus tard, c’est cette traduction qui fait autorité, et le premier mot de ce psaume particulier (placebo) finit par désigner, par glissement métonymique, la cérémonie des Vêpres des morts en elle-même. Lors de cette cérémonie, on faisait souvent appel à des professionnelles pour venir pleurer les morts, ce qui fait que le terme de placebo, utilisé dans des expressions comme « aller à placebo », finit par être fortement connoté, étant associé à de la duperie ou de la courtisanerie.

Petit à petit, ce terme gagne le monde médical pour désigner des traitements ou des préparations qui ont plus pour but de satisfaire les malades que de réellement les guérir. Même si les études plus solides méthodologiquement à propos du placebo datent du milieu du vingtième siècle, l’idée de duper une personne malade en lui administrant un traitement n’ayant a priori aucun autre effet que de la rassurer sur le fait qu’on s’occupe d’elle existe donc depuis très longtemps.

Néanmoins, définir un placebo en opposition aux traitements dotés d’efficacité spécifique peut être un peu trompeur sur le plan historique. En effet, de ce que l’on sait aujourd’hui de l’histoire de la médecine, nous avons de bonnes raisons de penser que l’immense majorité des traitements ou thérapies utilisées depuis l’aube de l’humanité jusqu’à relativement récemment (au moins jusqu’à Hippocrate, au 4ème siècle avant notre ère, voire jusqu’à la fin du 19ème siècle pour les historien•nes les plus pessimistes) était dénuée d’effets spécifiques, et qu’une bonne partie faisait même globalement plus de mal que de bien (comme par exemple la saignée administrée de manière systématique).

La rationalité médicale contemporaine a mis beaucoup de temps à émerger, et à chaque fois qu’un pas était fait dans cette direction, c’était toujours dans un mélange désordonné de magie, de mythes et de superstitions – et ce, des Égyptiens aux Grecs antiques. Malgré tout, c’est avec Hippocrate, puis Galien après lui, que certaines pratiques magiques s’éloignent peu à peu de la médecine, quand d’autres, comme l’usage d’amulettes par exemple, y restent encore longtemps attachées.

En tout cas, pour les médecins et les philosophes qui étudient la question, il est déjà clair à ce moment-là que des éléments comme les émotions, l’imagination ou la confiance sont des composantes à part entière du soin, qui peuvent avoir un effet sur la santé. Se pose d’ailleurs déjà la question éthique de savoir dans quelle mesure une partie de la population (les médecins, les savants) a le droit de mentir aux autres dans leur intérêt.

Se met alors en place petit à petit, et plus systématiquement à partir du 16ème siècle, l’usage du mensonge et de la tromperie dans le soin médical, qui va même en se rationalisant.

Une chose à retenir, c’est qu’au contraire de ce que l’on peut parfois entendre, ce n’est pas James Lind, au dix-huitième siècle, qui serait à l’origine de l’idée du placebo, avec son fameux protocole visant à tester l’effet de différents types de nourritures sur le scorbut. On trouve en effet des traces de l’idée de placebo bien plus loin, comme par exemple dans les travaux de Qusta ibn Luqa, en Syrie byzantine, et ce dès le 9ème siècle.

C’est précisément au lien qu’entretient le concept de placebo avec l’émergence de la méthodologie scientifique contemporaine qu’est consacré le chapitre suivant.

Chapitre 2 : Placebo, ritournelle de la médecine scientifique (p. 51)

Ce deuxième chapitre se focalise donc sur la place que le placebo occupe dans la méthodologie scientifique contemporaine, et en particulier en médecine et en pharmacologie. L’émergence des méthodes actuellement mises en place pour évaluer l’effet d’un traitement sur une pathologie est étroitement liée à notre compréhension de l’effet placebo. Et une chose est sûre, comme pour le reste, leur histoire commune est tout sauf linéaire.

L’idée fondamentale sous-jacente aux méthodes actuelles est celle du raisonnement contre-factuel. Il ne s’agit pas seulement de se demander : qu’est-ce qui se passe lorsqu’on prend le traitement X, mais également : qu’est-ce qui se serait passé si on ne l’avait pas pris ? L’effet spécifique du traitement X, c’est la différence entre ces deux observations. Comme on ne peut pas remonter dans le temps pour ne pas prendre le traitement et comparer avec le cas où on l’a pris, on instancie le raisonnement contrefactuel d’une façon plus réaliste (mais, bien sûr, jamais parfaite). Classiquement, on constitue des groupes de personnes comparables, c’est-à-dire avec la même distribution des facteurs qui pourraient avoir un rôle à jouer dans l’évolution de la pathologie (comme l’age, le genre, …). On donne le traitement que l’on veut tester à l’un des deux groupes (le groupe traitement) et on donne autre chose à l’autre groupe (le groupe contrôle). On peut par exemple donner un traitement déjà sur le marché et dont on a déjà prouvé l’efficacité : il s’agit alors de savoir si le nouveau traitement est meilleur que celui-là. Mais on peut aussi donner un placebo : soit un placebo pur (quelque chose qui n’a aucun effet clinique), soit un placebo impur (quelque chose qui a un effet clinique mais pas sur la pathologie que l’on veut traiter).

Cette manière de faire est une façon parmi d’autres de tester l’effet d’un traitement, adaptée à certaines situations et moins à d’autres. Il faut également que tout ce beau monde soit en double, voire triple aveugle : ni le•la patient•e (simple aveugle), ni le•la médecin qui donne le traitement (double aveugle), ni le•la statisticien•ne (triple aveugle) qui traite les données, ne doivent savoir qui a pris quoi. Le quadruple aveugle peut même être envisagé lorsque l’étude a été pré-enregistrée, et que les auteur•ices de l’article précisent à l’avance les données qui infirmeraient ou qui confirmeraient leurs hypothèses, ainsi que les tests statistiques qu’iels ont choisi de mener, pour quelles raisons, etc.

Bref, même si les protocoles peuvent varier, l’idée sous-jacente est la même : tester l’effet d’un facteur X, c’est regarder ce qu’il se passe lorsqu’on a X par rapport au cas où on n’a pas X, toute chose étant égale par ailleurs. Et si la médecine scientifique s’est développée en Europe dès la fin du dix-neuvième siècle et par suite principalement dans le monde « occidental », industrialisé et développé au cours du vingtième siècle, incorporant dans sa méthodologie des outils statistiques de plus en plus performants et pertinents, il faut ici également noter que l’idée de comparer les observations toute chose étant égale par ailleurs n’a, elle, rien d’occidentale par essence. En effet, on peut en retrouver des traces dans la médecine ayurvédique (remontant à plus de deux mille ans, en Inde), dans le livre de Daniel dans l’Ancien testament, en Chine au 2ème siècle de notre ère, ou encore dans le monde arable lors de l’âge d’or islamique, au tournant du premier millénaire de notre ère.

En résumé, ce que l’on apprend de ces deux premiers chapitres, c’est cela : partout dans le monde, pendant des millénaires, on a fait à peu près tout et n’importe quoi en termes thérapeutiques. Comme on l’a déjà évoqué, il y a en effet de bonnes raisons de croire que l’immense majorité des choses qu’ont inventé les humains pour se soigner relevaient, quand elles avaient un quelconque effet positif, de l’effet placebo, voire du simple effet du temps qui passe. Certaines pratiques, comme la saignée administrée de manière systématique, étaient même carrément plus nocives que bénéfiques, en général. Ça n’a pas empêché cette pratique d’émerger littéralement partout autour du globe 1, mais c’est bien en Europe occidentale que l’on a poussé les choses assez loin, la rendant particulièrement dangereuse.

Au milieu de ça, l’idée de comparer deux modalités, l’une où l’on donne le traitement, et l’autre où le donne pas, en fixant (autant que faire se peut !) tous les autres facteurs, a elle aussi émergé partout autour du monde. Le raisonnement contre-factuel, aussi contre-intuitif soit-il, a donné naissance à la méthode scientifique telle qu’on la connaît aujourd’hui, en particulier en médecine. Que cette dernière se soit développée principalement dans les pays industrialisés ces cent cinquante dernières années est une contingence de l’histoire, et il n’y a aucune raison de penser que les concepts et idées sous-jacents soient, par essence, « occidentaux ».

Comme l’argumentent les auteurs, penser qu’il y a une rupture fondamentale entre les idées qui sous-tendent la médecine contemporaine et les façons de penser non-occidentales conduit en fait à invisibiliser les contributions non-occidentales à la médecine – et paradoxalement, relève donc d’une certaine forme d’occidentalo-centrisme.

Chapitre 3 : L’effet placebo à la loupe (p. 101)

Après avoir détricoté l’histoire du placebo et l’émergence de la méthode expérimentale utilisée en médecine, ce troisième chapitre en vient à décrire plus précisément l’effet placebo à proprement parler.

L’effet placebo est un effet réel, physiologique et positif : des endorphines, c’est-à-dire des molécules qui ont pour effet de calmer la douleur, sont sécrétées par le cerveau, suite à une exposition du patient à un contexte qu’il interprète comme un contexte de soin. Ce n’est donc pas « un effet fantôme attribué à l’imagination, à la simulation ou à la simple stupidité. C’est un résultat physiologique lié à une action symbolique du contexte sur l’individu. » (p. 123)

Ainsi, quel que soit le traitement (même un traitement placebo) administré, on s’attend à observer une certaine évolution des symptômes. Cette évolution globale observée, c’est ce qu’on appelle la réponse au traitement. Cependant, cette réponse au traitement a deux composantes : un effet spécifique intrinsèque éventuel, et un ensemble d’effets non spécifiques. Ce que l’on veut, c’est évaluer la taille de l’effet spécifique, s’il existe, c’est-à-dire la taille de l’effet qui est vraiment dû au traitement administré. Pour ça, on doit donc évaluer la taille des effets non spécifiques à ce traitement (c’est-à-dire, pour revenir sur le raisonnement contrefactuel, les effets qui auraient été observés même sans ce traitement) et la soustraire à la réponse au traitement. Pour mesurer ces effets non spécifiques, il faut alors faire la même expérience sur un groupe contrôle, c’est-à-dire dans les mêmes conditions, mais en donnant un traitement qui, on le sait, n’a pas d’effets spécifiques, à savoir : un placebo.

Ce qu’on va mesurer dans le groupe contrôle, c’est la « réponse placebo ». Mais dans cette réponse, on n’a pas uniquement l’effet placebo ! En effet, la réponse placebo, par exemple la différence entre la douleur que des patient•es rapportent avant et après la prise du placebo, est une combinaison de plusieurs choses :

  • L’effet placebo à proprement parler.
  • Les effets de co-intervention. Il s’agit des effets de toutes les autres choses qui peuvent intervenir sur l’évolution de la santé du ou de la patient•e : d’autres interventions thérapeutiques, certains comportements ou encore le régime alimentaire.
  • Les effets inexorables. Il s’agit par exemple du fait que la pathologie en question finisse par passer « toute seule », c’est-à-dire uniquement grâce au propre système immunitaire de la personne.
  • Enfin, certains effets statistiques. Par exemple, la régression à la moyenne : si on score dans les extrêmes en termes de douleur, il est assez probable, statistiquement, qu’en nous redemandant un peu plus tard, on score sur des degrés moins extrêmes.

C’est donc bien au premier point – l’effet placebo – que l’on s’intéresse ici, qui n’est qu’une des multiples composantes de la réponse placebo.

Certains placebos sont « fermés » (la personne ne sait pas qu’elle prend un placebo), et d’autres sont « ouverts » (la personne sait qu’elle prend un placebo). La découverte intéressante de ces dernières années, à laquelle les auteurs ont d’ailleurs contribué, c’est que l’effet placebo peut se manifester même dans le cas où la personne sait qu’elle prend un placebo, c’est-à-dire où le placebo est donné sans tromperie ! À condition, cependant, que les mécanismes sous-jacents lui soit expliqués au préalable. Alors, quels sont ces mécanismes ?

Pour comprendre, les auteurs nous décrivent tout d’abord le modèle le mieux corroboré aujourd’hui du fonctionnement du cerveau concernant ses capacités à faire sens du monde qui nous entoure. Il faut imaginer que le cerveau fait sans cesse des inférences sur le futur : il prédit en permanence ce qui va arriver à partir des stimuli sensoriels qu’il reçoit, en prenant également en compte nos croyances et notre expérience passée.

Ces inférences sont systématiquement comparées à ce qui arrive vraiment. Lorsqu’il y a une erreur, c’est-à-dire une trop grande différence entre ce qui est prédit et ce qui est observé ou ressenti, on a deux possibilités. Soit on ajuste nos croyances suite aux perceptions qu’on a reçues ; soit on cherche à générer de nouveaux ressentis pour pouvoir confirmer nos croyances ! Nos croyances et nos attentes, d’une part, et les ressentis issus de nos perceptions, d’autre part, s’influencent ainsi les uns les autres.

L’effet placebo, c’est l’effet qu’ont certaines attentes sur la façon avec laquelle on va vivre certains ressentis, dans certains contextes. En d’autres termes, le soulagement de certains symptômes est donc dû à la fois à la guérison biologique (qu’elle soit spontanée ou produite par un principe actif) et à la fois au fait que le cerveau interprète certains signaux corporels comme étant le signe d’une guérison. Un cercle vertueux se met en place : dans un contexte que l’on interprète comme un contexte de soin, on va s’attendre à aller mieux. Ces attentes vont alors avoir deux effets, qui se combinent. D’une part, elles vont modifier la façon avec laquelle on interprète certains signaux envoyés par le corps, qu’on va par exemple interpréter comme des signaux de guérison alors même que ce n’est peut-être que du bruit statistique. D’autre part, elles vont déclencher effectivement des sensations de bien-être et de relâchement, en particulier par des sécrétions d’endorphines, dans le but précisément de minimiser l’erreur entre les prédictions du cerveau et les ressentis effectifs ! Une sorte de prophétie auto-réalisatrice au niveau individuel, en somme.

Dans tous les cas, on va se sentir mieux, ce qui va valider les prédictions du cerveau, confirmant que les attentes étaient les bonnes, et ainsi de suite. Cet effet va donc avoir tendance à s’auto-amplifier.

Il y a globalement deux façons pour qu’un contexte soit associé à un effet placebo. D’un coté, le conditionnement et l’apprentissage : les expériences passées où l’on a associé tel contexte à une guérison ou à une amélioration de notre état de santé vont s’inscrire neurologiquement et provoquer les mêmes effets dès lors que les éléments du contexte seront de nouveaux là. D’un autre coté, les suggestions verbales : celles-ci, de la part du médecin, du personnel soignant, ou de nos proches, par exemple, vont générer des attentes plus ou moins explicites, et ce sont ces attentes qui, on le rappelle, vont ensuite générer l’effet placebo.

La littérature a mis en évidence tout un ensemble de facteurs contextuels qui peuvent jouer sur l’effet placebo, comme des facteurs liés aux soignant•es (par exemple, la croyance du thérapeute dans l’efficacité du traitement), ceux liés aux soigné•es (ses croyances, ses représentations culturelles, son expérience passée, …), ceux liés à la relation de soin (la confiance entre patient et médecin), ceux liés au traitement (type de diagnostic, le prix, la forme, ou encore l’apparence du traitement), et enfin des facteurs environnementaux (le lieu du soin, la narration ou le rituel mis en place).

L’effet placebo désigne donc un ensemble de mécanismes psycho-biologiques qui vont passer par le système nerveux central, et qui vont principalement avoir un effet (encore une fois, réel et positif) sur des symptômes subjectifs et graduels, comme la douleur, l’anxiété, l’inconfort ou la fatigue. Cependant, un effet placebo n’agira pas sur un organe pour le réparer : il ne guérit pas à proprement parler, contrairement à ce qu’on a pu croire pendant des décennies.

Bien sûr, il peut avoir des effets indirects : si une personne sous chimiothérapie parvient à diminuer les douleurs dues aux effets secondaires via un effet placebo, celle-ci pourra mieux accepter son traitement, mais également être moins déprimée, et ainsi de suite, ce qui pourra finalement avoir un effet concret sur sa guérison. Mais il ne s’agira pas d’un effet direct de guérison par le placebo, et encore moins d’un effet mystérieux de l’esprit sur le corps.

Bien sûr, maintenant que l’on comprend comment fonctionne l’effet placebo, on peut aussi comprendre qu’il puisse se manifester également chez les enfants, même en très bas âge, ainsi que sur les animaux de compagnie, comme les chats, les chiens, mais également les chevaux ou les animaux d’élevage comme les vaches.

Dans ces derniers cas, il faut avoir en tête qu’un effet très important se rajoute en réalité aux effets placebo : l’effet placebo par procuration (ou « proxy »). Cet effet n’agit pas directement chez l’individu (humain ou non) concerné, mais chez la personne qui observe (et qui attend) des effets. Par exemple, il peut s’agir des parents qui vont avoir une certaine attente concernant la guérison de leur bébé, ou bien l’effet supposé (mais, jusqu’à preuve du contraire, inexistant) du sucre sur le niveau d’excitation de leur enfant. On peut également penser aux propriétaires d’animaux de compagnie qui « voient » leur état s’améliorer après une visite chez le•la vétérinaire. En plus des effets spécifiques et non-spécifiques (placebo) du traitement, il peut donc se rajouter une nouvelle couche, l’effet placebo que vit la tierce personne observatrice, par procuration.

En tout cas, c’est pour toutes ces raisons que l’argument : « ça marche sur mon bébé/mon animal de compagnie, donc ça ne peut pas être un effet placebo » pour défendre des thérapies n’ayant pas fait la preuve de leur efficacité, ne tient pas la route.

Chapitre 4 : Nocebo : dark side of the mind (p. 209)

Après ce gros chapitre, central, on en vient au frère jumeau maléfique du placebo : l’effet nocebo. Le quatrième chapitre commence par une histoire également très fournie du concept, avant d’en présenter les effets réels et les mécanismes en jeu.

Fondamentalement, il se passe un peu la même chose que pour l’effet placebo, mais dans le cas des attentes négatives. Si on est inquiet d’avoir mal suite à la prise d’un comprimé, par exemple, on va générer de l’anxiété, ce qui va être interprété comme une menace, menace à laquelle on va réagir physiologiquement en sécrétant certaines molécules qui inhibent les récepteurs des molécules qui pourraient, justement, calmer la douleur. Ce mécanisme est l’un des mécanismes responsables de l’effet nocebo décrit dans l’ouvrage. Les auteurs précisent cependant qu’il en existe d’autres connus, et sûrement de nouveaux à découvrir.

Le principe est toutefois globalement celui-ci : l’anxiété, traduite par des attentes négatives, comme la peur d’avoir mal, produit ou augmente la douleur perçue, ce qui renforce la menace perçue en retour, puisque les attentes ont effectivement été confirmées ! Et c’est le cercle vicieux qui se met en route.

Comme dans le cas de l’effet placebo, les attentes vont également nous faire percevoir nos ressentis de manière biaisée. Il est possible, par exemple, que soumis•e à ces attentes, on interprète une douleur comme un effet secondaire du médicament (et donc la preuve qu’on avait bien fait d’avoir peur !), alors qu’on aurait peut-être ignoré ladite douleur en temps normal.

Les facteurs contextuels qui produisent cet effet sont aussi à peu près les mêmes que pour l’effet placebo : les suggestions verbales, les postures des soignant•es ou des proches, les croyances que l’on a, et ainsi de suite.

Des effets d’influence et de contagion social peuvent également rentrer en ligne de compte. C’est assez compréhensible, puisque nous sommes des êtres sociaux. Pour produire des inférences, on se base sur l’information accessible dans notre environnement. Or, pour les êtres sociaux, par définition, les autres individus sont une source importante d’information : on va inférer l’effet d’un médicament en observant l’effet qu’il a (ou que l’on croit qu’il a) sur des personnes de notre entourage. Ainsi, si plusieurs personnes nous rapportent avoir eu des effets secondaires désagréables suite à la prise d’un médicament, cela va forcément jouer sur notre propre vécu de la chose, indépendamment de l’importance réelle de ces effets.

Chapitre 5 : Le placebo dans le soin contemporain (p. 275)

Enfin, l’ouvrage se clôt sur une discussion éthique et politique autour de la place du placebo dans le système de santé et plus généralement dans le soin contemporain.

Pour ça, trois notions d’« efficacité » sont d’abord décortiquées :

  • L’efficacité (efficacy) : c’est l’effet spécifique mesuré en conditions idéales (issues d’essais contrôlés randomisés).
  • L’effectivité (effectiveness) : il s’agit de l’effet spécifique en conditions réelles, c’est-à-dire où l’on prend en compte une certaine part d’aléatoire sur le contexte de soin sur lequel on n’a pas forcément de prise directe.
  • Et l’efficience : le résultat par unité de ressources (souvent, par euro investi).

Ce qu’un essai clinique peut nous apprendre, c’est si oui ou non tel traitement a un effet spécifique. Le point important, c’est que du point de vue du ou de la patient•e, ce qui compte vraiment, ce n’est pas de maximiser l’effet spécifique de l’intervention, mais de maximiser l’effet total ! Et il se trouve que, parfois, une intervention avec un effet spécifique avéré peut-être globalement moins efficace qu’une autre intervention sans effet spécifique (ou avec un effet spécifique moindre), simplement parce que dans ce second cas les effets placebo seront plus élevés pour le•la patient•e en question.

C’est donc une question, en général, difficile, qui nécessite une grille de lecture éthique – ainsi que politique, lorsqu’on réfléchit, par exemple, à un niveau plus global d’un système de santé dans son ensemble. Le raisonnement uniquement « technique », c’est-à-dire focalisé sur l’existence d’un effet spécifique, n’est donc pas suffisant pour traiter de la question – bien qu’il reste on ne peut plus nécessaire.

L’ouvrage se conclut par une discussion sur les thérapies alternatives et complémentaires (TAC). Celles-ci n’ont, en général, pas fait la preuve de leur efficacité spécifique, mais il se trouve que leurs promoteurs les plus subtils ont compris comment en maximiser les effets non spécifiques. En particulier, ils parviennent souvent à développer une relation de confiance assez robuste, ce qui prend du temps et demande de l’engagement de la part du ou de la praticien•ne. Dans un système de santé où ce temps et cet engagement viennent à manquer, on peut alors comprendre l’attrait que peuvent exercer ce type de pratiques, puisque comme les auteurs se sont efforcés de le montrer dans tout l’ouvrage, les dimensions psychologiques et sociales du soin ne sont absolument pas des aspects périphériques, mais bien une partie intégrante de celui-ci.

Les auteurs posent alors une question fondamentale : dans quelle mesure devons-nous laisser aux TAC le privilège de ces effets contextuels ? En effet, la perception d’un certain degré de dépersonnalisation dans les soins dits conventionnels, comme ceux procurés à l’hôpital ou chez le•la généraliste, est un facteur important dans le recours aux TAC. On devrait alors en profiter pour se demander comment faire pour maximiser les effets non spécifiques (dont l’effet placebo) dans les soins qui ont fait la preuve de leur efficacité propre, et parallèlement, pour minimiser leurs effets négatifs, liés par exemple à des prises en charge de plus en plus appauvries sur le plan du contact humain. De nouveau, ces questions relèvent de choix éminemment politiques.

Remerciements

Je tiens à remercier Richard Monvoisin pour sa relecture d’une première version de cet article. Merci également à Sohan Averseing & Eva Vives pour leur relecture et leurs retours avant publication.

La science est-elle dénuée de valeurs ?


Lors notre rencontre annuelle hivernale en février 2026, j’avais fait à mes camarades du Cortecs une petite présentation d’épistémologie à propos de la place des valeurs en science. Je ne suis pas spécialiste de la question mais j’avais toutefois, pour l’occasion, compulsé un peu la littérature sur le sujet, en particulier la synthèse que Kevin C. Elliott a proposé chez Cambridge Elements, Values in Science2. On s’est dit que ça pourrait être une bonne occasion de transformer cette présentation en article, afin de pouvoir le partager à plus de personnes. Voilà donc une introduction en bonne et due forme à la question des valeurs en science. Ça reste introductif, le but étant surtout de donner le panorama global de ces réflexions, et vous permettre au moins de repartir avec l’idée que c’est un peu plus compliqué que ce que l’on pourrait croire a priori–et ce, que l’on soit un•e constructiviste radical•e ou un•e indécrottable objectiviste ou réaliste. Surtout, il faut bien garder à l’esprit que l’on n’aura fait qu’explorer les réflexions à la surface de ce que peut produire la littérature sur ce sujet en philosophie des sciences contemporaine. Enfin, je ne suis moi-même pas forcément totalement d’accord avec tout ce qui est écrit ici, et au sein du Cortecs c’est un sujet de discussion régulier, donc on ne partage pas non plus une vision parfaitement homogène. Bref, rentrons dans le cœur du sujet.

Introduction

Dans tout cet article, on entend par « valeur » une chose ou une qualité qui est désirable ou qui mérite d’être poursuivie. Commençons alors dans le vif du sujet avec la question suivante : la science est-elle ou doit-elle être influencée par des valeurs ?

Une première distinction très importante à opérer pour affiner un peu la question est celle entre des valeurs épistémiques (VE) et des valeurs non-épistémiques (VNE).

Une VE, c’est une valeur qui est dirigée dans le sens de la production ou de la justification d’une connaissance. Par exemple, le succès empirique est généralement perçu comme une bonne VE : toute chose égale par ailleurs, on préfère une théorie qui dit des choses sur le monde qui sont effectivement observées plutôt qu’une théorie qui se trompe, par exemple. La parcimonie est également une autre VE bien connue : si on a deux théories qui ont le même succès empirique, on préférera la théorie qui repose sur le plus d’hypothèses déjà corroborées par ailleurs, c’est-à-dire celle qui est la plus parcimonieuse en nouvelles hypothèses ou en nouvelles entités. Si ça vous semble évident, c’est parce que le succès empirique ainsi que la parcimonie font déjà partie des valeurs (épistémiques) que vous considérez comme importantes !

La philosophie des sciences regorge de listes de VE, qui comprennent le plus souvent le succès empirique et la parcimonie, mais également la réfutabilité, le pouvoir prédictif, le pouvoir explicatif, le pouvoir unificateur, la fécondité, le fait qu’une théorie est soutenue par plusieurs types de preuves différentes, etc.3. L’objectivité et la rationalité, plus généralement, sont également des valeurs très importantes en science. La question ainsi posée plus haut est donc un peu triviale : la science repose évidemment sur des valeurs, ne serait-ce que des valeurs épistémiques.

C’est là où un deuxième type de valeurs rentre en jeu : les valeurs non épistémiques (VNE). On peut penser au fait de faire du profit en vendant un médicament, mener une politique publique efficace (par exemple, qui remplit certains buts donnés en minimisant les coûts), atteindre la gloire et la reconnaissance académique, améliorer le rendement électrique de certaines machines, travailler dans le sens d’une plus grande justice sociale, etc. Ce sont des valeurs, mais elles ne sont pas particulièrement orientées (directement, en tout cas) dans le sens de la production de connaissances. Elles peuvent même parfois être perçues comme opposées à ce dernier but (ce qui n’est, en fait, pas forcément le cas, comme on va le voir).

On peut alors un peu mieux cerner la pertinence de la question soulevée au début de cet article : puisque la science est généralement perçue comme étant le parangon de la production de connaissances fiables sur le monde, devrait-on laisser des VNE intervenir dans le processus, faire tout pour éviter que ces valeurs interviennent, ou au contraire carrément y implémenter activement certaines d’entre elles ? Par exemple, est-il légitime qu’une théorie en biologie soit préférée (ou rejetée) parce qu’elle (ne) correspond (pas) aux préférences idéologiques de ses auteur•ices ? Ou bien, doit-on orienter les thèmes de recherche en fonction de revendications politiques de la population ?

Dans cette introduction à propos de la place des valeurs en science, on va voir qu’il n’y a pas de réponse simple à cette question. En particulier, si votre premier réflexe en lisant le paragraphe ci-dessus a été : « évidemment qu’on devrait empêcher les VNE d’intervenir en science, la science ne s’occupe pas des questions politiques ou morales, elle est juste là pour dire le vrai », la suite de l’article devrait vous apporter un peu de contradiction intéressante.

On va donc tenter d’y voir plus clair. Pour ça, je vais suivre ici le découpage du livre de Elliott, en posant trois questions :

  1. Comment les valeurs influencent « la science » ?
  2. Doit-on activement incorporer des valeurs en science ?
  3. Comment gérer la place des valeurs en science de manière responsable ?


Comment les valeurs influencent-elles « la science » ?

On pourrait simplement se dire : si on comprend « la science » comme une entreprise collective principalement orientée vers la production de connaissances, c’est-à-dire poursuivant principalement des buts épistémiques, alors on devrait faire tout ce que l’on peut pour que les VNE n’interviennent pas dans le processus. Du coup, pourquoi est-ce que c’est plus compliqué que ça ?

Premièrement, dans les faits, la différence entre les VE et les VNE n’est pas toujours évidente à réaliser concrètement. Pour prendre un exemple simple, imaginons la question : « ce pont est-il assez solide ? » Il semblerait que ça soit une question purement factuelle à première vue : une fois définie la solidité d’un pont et les critères permettant de l’évaluer, on peut répondre à cette question sans faire intervenir de VNE. Le problème, c’est qu’ici la définition même de la solidité et des critères d’évaluation ne sont pas un détail : ils constituent en fait le cœur du problème, et ils sont nécessairement chargés de VNE. En effet, la définition de la solidité est forcément adossée à l’usage prévu pour le pont ainsi qu’à la durée sur laquelle on souhaite que le pont soit solide, et ces éléments ne sont pas donnés objectivement de nulle part, ils correspondent à des choix pratiques réalisés à certains moments, dans certaines conditions, sous certaines contraintes (par exemple, avec un budget limité). De plus, étant donné qu’il s’agit d’une décision à prendre en situation d’incertitude (même si on a des critères que l’on considère bons, on n’est jamais à l’abri d’un imprévu), il faut juger des coûts de juger à tort que le pont est solide alors qu’il ne l’est pas (faux positif) et de ceux de juger à tort que le pont n’est pas solide alors qu’il l’est (faux négatif). Dans les situations socio-scientifiques complexes, ces deux types d’erreurs n’ont généralement pas le même coût–en tout cas, ce ne sont habituellement pas les mêmes populations qui portent les coûts des deux types d’erreur. Bref, il s’agit d’une question éminemment politique, qui ne peut être réglée en ne faisant intervenir uniquement des VE. On peut appliquer le même type de raisonnement à des affirmations comme : « ce médicament a un rapport coût/bénéfice favorable », ou bien « cette centrale nucléaire est sûre ». Mais on y reviendra.

De plus, certaines valeurs comme la simplicité sont souvent ambiguës : parfois synonyme de parcimonie des hypothèses, on peut aussi comprendre la simplicité dans son sens cognitif (« plus simple à comprendre »), voire même esthétique. Dans certains cas, la différence entre les deux n’est pas aussi claire qu’on pourrait imaginer. En mathématiques, l’idée que certaines preuves seraient plus « élégantes » que d’autres est un bon exemple d’une telle ambiguïté.

Deuxièmement, même si on s’applique à ne faire intervenir que des valeurs épistémiques dans le choix entre plusieurs hypothèses ou théories, des VNE peuvent intervenir dans la façon avec laquelle ces VE sont implémentées. Comme le notait Thomas Kuhn, même si des VE sont partagées au sein d’une même communauté, les chercheureuses qui constituent cette communauté peuvent être en désaccord sur (1) à quel point telle théorie exhibe telle valeur et/ou (2) comment on pondère les valeurs les unes par rapport aux autres. En d’autres termes, les chercheureuses peuvent être d’accord que la parcimonie et le pouvoir prédictif sont des VE importantes. Cependant, iels pourraient (1) ne pas juger la parcimonie (ou le pouvoir prédictif) d’une théorie donnée de la même façon. Par exemple, lors de l’émergence de l’héliocentrisme copernicien comme concurrent au modèle de Ptolémée (géocentrique), certaines personnes pourraient trouver le modèle copernicien plus parcimonieux que celui de Ptolémée (car il repose sur moins d’hypothèses ad hoc, par exemple), alors que d’autres pourraient penser que le modèle de Ptolémée est plus en accord avec les écrits d’Aristote et la vision de l’Église, vision installée depuis longtemps, ce qui le rend plus parcimonieux en hypothèses. On pourrait aussi penser que (2) les personnes devant évaluer les qualités relatives de différentes théories pourraient donner plus d’importance, en cas de conflits de valeurs, à une valeur plutôt qu’à une autre. Par exemple, il était assez notoire à l’époque que le modèle héliocentrique, bien que plus parcimonieux ou plus « simple », souffrait de certaines inconsistances empiriques, c’est-à-dire qu’il n’arrivait pas à rendre compte de certaines observations, alors que le modèle de Ptolémée, lui, en était capable. Même si on pourrait se mettre d’accord sur le fait que le modèle de Copernic est plus simple mais moins consistant que le modèle de Ptolémée, le choix entre les deux dépendrait encore du poids relatif qu’on donne à ces deux valeurs. Si la parcimonie est jugée plus importante que la consistance empirique, alors le modèle de Copernic est meilleur. Sinon, c’est le contraire.

Le point important ici est que (1) comme (2) peuvent reposer sur des VNE.

Enfin, il faut aussi reconnaître que ce qu’on appelle généralement « la science » n’est justement pas qu’une entreprise collective de production de connaissances, mais qu’elle s’inscrit dans un certain contexte socio-historique. De ce point de vue, il est donc très plausible que des VNE interviennent à plusieurs endroits. Pour préciser un peu ce point et ne pas en rester à cette formulation un peu vague et donc un peu vide, on peut reprendre le schéma que K. C. Elliott fournit dans l’ouvrage sur lequel cet article est fondamentalement basé, et qui distingue quatre façons avec lesquelles les VNE peuvent influencer « la science », à savoir :

  • Dans le fait de guider la science a priori, c’est-à-dire pour décider de financer et de donner la priorité à tel ou tel projet plutôt qu’à un autre ou bien le fait de poser certaines questions plutôt que d’autres. (Steering Science.)
  • Dans la gestion concrète de la science, c’est-à-dire de choisir du matériel afin de produire des données, de développer un certain climat au sein du laboratoire, ou bien de respecter les personnes participant à la recherche. (Managing Science.)
  • Dans le fait de faire de la science, c’est-à-dire de concevoir les études, de créer des modèles, de choisir les catégories de base avec lesquelles on va travailler, ou encore de tirer des conclusions. (Doing Science.)
  • Enfin, dans le fait d’utiliser la science, c’est-à-dire de mettre sur le marché (informationnel ou économique, public ou privé) certaines applications de la connaissance produite, comme le fait de communiquer ses résultats (aux médias, au grand public), de formuler des prescriptions, de développer une politique publique ou encore de prendre des décisions. (Using Science.)
Reproduction du schéma global des différents endroits où des valeurs peuvent intervenir en science (Figure 1, Elliott 2022).

En anticipant un peu, on comprend que promouvoir des valeurs non épistémiques au niveau du management de la science (comme promouvoir une certaine liberté de recherche, une certaine diversité sociale et donc cognitive au sein du laboratoire, ou encore promouvoir des valeurs de respect et de vigilance quant aux mécanismes de pouvoir illégitimes), ou bien tout simplement s’assurer que les équipes de recherche aient le moins de conflits d’intérêt possible vis-à-vis de leurs financeurs, par exemple, peut in fine permettre de produire de meilleures connaissances. Pourtant, toutes les valeurs que je viens de citer ne sont pas à proprement parler des valeurs épistémiques pures, bien qu’elles puissent quand même influencer la poursuite des buts épistémiques de la science. C’est donc aussi pour ça que la question posée au début de cet article est tout sauf évidente.

Ayant abouti au constat qu’on ne peut probablement pas se passer des VNE dans la conduite de la recherche scientifique, on va pouvoir se poser une nouvelle question, qui va nous permettre d’affiner de nouveau notre réflexion.


Doit-on activement incorporer des valeurs en science ?

Encore une fois, posée ainsi, la question n’est pas assez précise et la réponse est trivialement : on n’a pas le choix, puisqu’il y a au grand minimum des valeurs épistémiques qui interviennent en science.

On doit donc affiner un peu notre questionnement, qui devient : Est-ce que les VNE doivent jouer un rôle actif dans le raisonnement scientifique, c’est-à-dire dans la partie « faire de la science » dans le schéma ci-dessus ?

Examinons maintenant les principaux arguments des personnes soutenant un « idéal sans valeur », value-free ideal (VFI) en anglais, c’est-à-dire les personnes qui répondent plutôt « non » à la question ci-dessus.

Arguments pour le VFI

Les tenant•es du VFI, bien qu’ils ne tiennent évidemment pas tous une même position, ne sont généralement pas naïf•ves : iels reconnaissent que les VNE jouent à différentes étapes du processus de production de connaissances, et ils reconnaissent que le VFI est un idéal, justement, c’est-à-dire un ensemble de normes abstraites qui ne sont pas forcément toujours respectées dans la pratique.

Éviter le raisonnement motivé (wishful thinking)

Le premier argument pro-VFI est qu’intégrer des VNE dans le raisonnement scientifique peut écarter des buts épistémiques de la science en tendant vers le raisonnement motivé, le « wishful thinking ». On peut être motivé•e pour travailler sur un sujet donné pour des raisons non épistémiques (c’est pratiquement toujours le cas), mais ces raisons ne peuvent pas être mobilisées dans la défense effective d’une théorie ou dans l’acceptation ou le rejet d’une conclusion. C’est souvent la première peur que l’on peut avoir lorsqu’on entend parler de valeurs qui interviendraient en science, et la raison pour laquelle on peut être un peu gêné•e a priori : c’est parce qu’on entend cette question comme « des considérations morales, politiques ou métaphysiques doivent faire partie intégrante des critères utilisés collectivement pour défendre une théorie scientifique ». Pour les tenant.e.s du VFI, ce « wishful thinking », qui est inévitable au niveau individuel, doit pouvoir être éviter au niveau collectif, et c’est précisément pour ça qu’il faut se méfier de l’introduction des VNE au niveau du raisonnement scientifique.

Garantir l’autonomie de la décision

Le deuxième argument repose sur la volonté de garantir l’autonomie des décideur•euses : les scientifiques doivent travailler sur des faits, et livrer leur conclusions pour qu’ensuite des décisions (éventuellement politiques) puissent être prises. Quand on parle de « décideur•euses » c’est ici au sens large, ça fonctionnerait aussi dans une société où les décisions seraient moins centralisées qu’aujourd’hui. L’idée c’est que le groupe social des scientifiques n’est pas représentatif de la population générale, il n’est donc pas légitime (d’un point de vue démocratique) pour prendre des décisions qui incluent des considérations non épistémiques, mais uniquement pour se prononcer sur les questions relatives à leur champ de connaissance.

Préserver la confiance

Le troisième argument consiste à vouloir préserver la confiance du public dans la science : celle-ci peut diminuer si le public perçoit que les scientifiques sont motivé•es par des considérations autre que la poursuite de la connaissance. Ainsi, mettre en avant le VFI et tenter de s’en approcher du mieux possible est une condition nécessaire pour préserver cette confiance.

Il est assez intéressant de remarquer que si le premier argument repose sur des considérations épistémiques, ce n’est pas le cas des deux autres : c’est pour des raisons non épistémiques que ceux-ci soutiennent un idéal scientifique au sein duquel uniquement des valeurs épistémiques doivent intervenir !

Les arguments anti-VFI

On peut grosso modo énumérer quatre grands arguments contre le VFI : l’argument du « gap », l’argument de l’erreur, l’argument des buts et enfin l’argument des concepts.

L’argument du gap

Cet argument part du fait que les théories sont sous-déterminées par l’expérience. Autrement dit, il est rare que les données empiriques disponibles puissent invariablement discriminer entre plusieurs propositions théoriques. Ce « gap » sera alors souvent rempli par des considérations non empiriques, ou plus généralement qui ne reposent pas uniquement sur des arguments rationnels ou des VE, mais qui font intervenir des VNE. Dans certains cas, même ce qui compte comme preuve va faire l’objet d’une négociation entre chercheur•euses. Les personnes qui rejettent le VFI vont alors enjoindre à reconnaître ce fait et à expliciter les VNE sous-jacentes, plutôt que de faire comme si elles n’intervenaient pas.

À cet argument, les pro-VFI répondent qu’il y a une différence entre reconnaître ce fait et faire jouer activement ces VNE. Ainsi, s’il est nécessaire d’identifier les VNE éventuelles lorsqu’elles interviennent, c’est dans le but de les éliminer, in fine, et de ne garder que les VE comme guide.

Ce à quoi les anti-VFI répondront, classiquement, que la différence entre VE et VNE n’est pas claire en pratique, voire même non pertinente dans certains cas.

L’argument de l’erreur

Lorsqu’on choisit une hypothèse plutôt qu’une autre, par exemple lorsqu’il s’agit de savoir si un médicament a une efficacité spécifique (statistiquement, significativement supérieure à l’administration d’un placebo), on peut faire deux erreurs possibles : dire qu’il est efficace alors qu’il ne l’est pas (faux positif), ou bien dire qu’il n’est pas efficace alors qu’il l’est (faux négatif). En général, on va donner un seuil de significativité à 5 % (par exemple), ce qui fait qu’on accepte 5 % de cas de faux positifs. Quoiqu’il en soit, les coûts associés aux faux positifs et aux faux négatifs ne sont pas symétriques et ne sont généralement pas portés par les mêmes groupes sociaux, qui n’ont d’ailleurs pas tous le même pouvoir de décision dans la négociation. Pour donner un exemple simple : un faux positif risque de nuire au malade, alors qu’un faux négatif risque de nuire au laboratoire pharmaceutique. Le fait de privilégier un type d’erreur plutôt qu’un autre est donc une décision (souvent implicite) éminemment politique. En d’autres termes, lorsqu’on dit « cette étude montre que tel médicament a un rapport bénéfice/risque favorable » on est pas en train d’énoncer uniquement des faits détachés de toute réalité sociale, mais bien une affirmation où les faits et les décisions morales, éthiques ou politiques se confondent sans pouvoir être clairement différenciés en général.

Les tenant•es du VFI peuvent répondre à cet argument en disant que si le choix d’un seuil de significativité est chargé de VNE, le fait que les résultats d’une étude particulière se situent au-dessus ou au-dessous de ce seuil est quelque chose qui peut être jugé uniquement avec des VE (à savoir ici, les outils statistiques classiques de tests d’hypothèses). Les scientifiques pourraient donc énoncer leurs résultats sans donner de seuil, et la décision de savoir si ces résultats sont significatifs reviendrait donc aux décideur•euses désireux•ses d’utiliser ces résultats pour une application concrète.

Ce à quoi les anti-VFI répondent qu’une telle façon de faire semble hautement irréaliste, et que le fait de choisir un seuil et de l’assumer comme étant un choix chargé de VNE semble être beaucoup plus acceptable d’un point de vue pratique comme éthique.

L’argument des buts

Cet argument a déjà été un peu cité, et il nous semble aisément acceptable : la plupart du temps, les buts de la recherche ne sont pas uniquement épistémiques. Dans ce cas, on comprend que les décisions permettant de choisir entre plusieurs propositions ne peuvent pas reposer uniquement sur des VE.

L’argument des concepts

Enfin, le dernier argument repose sur le fait que les concepts même que l’on utilise dans la recherche peuvent être chargés de certaines représentations sociales et donc de VNE. En sciences sociales, par exemple, on parle des concepts comme « délinquance », « criminalité », « chômage », « pollution » ou « terrorisme » comme de concepts « épais », c’est-à-dire qui possèdent à la fois une dimension descriptive et normative. Selon comment on opérationnalise le concept en question, c’est-à-dire comment on le transforme en variable mesurable, on ne va littéralement pas observer la même chose. La façon avec laquelle certains phénomènes socio-politiques nous apparaissent va donc dépendre de nos présupposés (épistémiques et non épistémiques). Notons que ce n’est pas propre aux sciences sociales, la-dite « charge théorique des observations » existe dans toutes les disciplines.

Ce fait peut être vu comme un mal nécessaire, c’est-à-dire quelque chose qui tend à nous éloigner de nos buts épistémiques, mais dont on peut limiter les effets néfastes si on l’accepte et qu’on tente de prendre en considération les conséquences possibles d’utiliser un concept plutôt qu’un autre.

Cependant, il peut aussi être considéré comme une bonne chose : parfois, pour avoir le concept le plus pertinent possible (à des fins purement épistémiques !), on a besoin d’y intégrer les considérations non épistémiques attachées à ce concepts, en particulier les significations particulières qu’en donnent les acteurs sociaux considérés.

Par exemple, dans un article étudiant l’effet causal de l’interventionnisme militaire sur les actes terroristes, les auteur•ices explicitent la définition de « terrorisme » qu’iels choisissent, en reconnaissant qu’elle est hautement chargée de représentations non neutres, puisqu’elle correspond à la définition des décideur•euses politiques occidentaux•ales qui combattent le terrorisme. Mais ce fait-là est précisément ce qui donne à cette définition toute sa pertinence, dans le cadre de leur recherche :

« En d’autres termes, le fait que le thermomètre ne mesure pas la chaleur objective n’est pas un problème. Il mesure très bien le sentiment de chaleur produit par un groupe d’acteurs particulier, or c’est précisément ce qui nous intéresse. Un usage réflexif de cette littérature est donc non seulement possible mais également utile et urgent pour comprendre les origines du phénomène que le discours dominant appelle, en Europe et en Amérique du Nord, « terrorisme ». » 4

Les tenant•es du VFI pourraient, comme pour l’argument de l’erreur, proposer que les chercheureuses ne prennent pas position quant à la meilleure définition à prendre du concept, mais présentent les différentes définitions possibles et les résultats obtenus pour chaque définition. En dehors du fait que le choix, même étendu, d’un ensemble fini de définitions reste toujours un choix, cette façon de faire semble assez inconcevable étant donnée la réalité de la recherche scientifique. De même que pour l’argument de l’erreur, il semble plus réaliste que ce choix soit interne à la science, mais qu’il soit explicité, assumé et argumenté plutôt que passé sous silence.

En conclusion de cette partie, il est clair qu’il n’y a pas de réponse évidente et universelle à la question que l’on s’est posée plus haut, à savoir : « Est-ce que les VNE doivent jouer un rôle actif dans le raisonnement scientifique, c’est-à-dire dans la partie « faire de la science » dans le schéma ci-dessus ? »

En d’autres termes, aucune des deux positions, pro-VFI ou anti-VFI, ne semble trivialement fausse, et la force relative des différents arguments donnés plus haut dépend beaucoup du contexte précis dans lequel on est, c’est-à-dire du cas étudié.

Nous sommes à présent mûr•es pour la troisième partie de cet article, où nous partons du principe que l’incorporation de VNE dans le processus scientifique est inévitable, à un point ou à un autre du schéma ci-dessus. La question est donc maintenant : comment faire avec ?


Comment gérer la place des valeurs en science de manière responsable ?

La littérature met en lumière au moins trois stratégies pour prendre en considération la place des valeurs en science.

La première stratégie propose de laisser les personnes directement impactées par la recherche décider des considérations non épistémiques qui leur parlent. Encore une fois, « mesurer un niveau de pollution » pose la question non seulement technique des mesures à réaliser concrètement, mais également celle du seuil à prendre en compte pour considérer qu’un environnement est pollué ou simplement celle des personnes (ou plus généralement des êtres vivants) touchées par ladite pollution. La façon la plus éthiquement responsable de faire pourrait donc être de négocier ces seuils en prenant directement en compte les intérêts des personnes touchées par la pollution.

La deuxième stratégie consiste à choisir les bons rôles pour les valeurs. En effet, si les valeurs peuvent avoir un rôle direct problématique (wishful thinking), elles peuvent avoir un rôle indirect bénéfique, en servant efficacement l’atteinte des buts épistémiques. Par exemple, promouvoir la diversité et la justice sociale au sein des communautés scientifiques peut permettre de diviser le travail collectif plus efficacement, en explorant des hypothèses qu’une communauté plus homogène n’aurait pas forcément pu imaginer, et in fine favoriser la production de connaissances scientifiques mieux fondées. La promotion de valeurs non épistémiques à ce niveau peuvent donc mener à mieux satisfaire des buts épistémiques.

Enfin, la troisième stratégie consiste à gérer ces VNE collectivement : si l’individu est sujet au raisonnement motivé, on peut espérer que dans certaines conditions, l’interaction critique entre ces individus peut quand même faire émerger les meilleures hypothèses, c’est-à-dire les hypothèses qui sont les mieux fondées épistémiquement (empiriquement et théoriquement), indépendamment des préférences initiales des chercheurs, des rapports de pouvoir politique ou économique en présence ou plus généralement des cadres idéologiques sous-jacents.

C’est une idée qui remonte au moins à Popper, que l’objectivité de la science n’est pas due à l’objectivité des scientifiques : les scientifiques, qu’iels fassent de la physique des particules ou de la sociologie, ne sont pas objectif•ves ou neutres. Iels ont des préférences initiales, qu’elles soient métaphysiques, morales ou idéologiques. Cela ne peut en être autrement. L’objectivité de la science, c’est l’objectivité qui ne peut résulter que de la critique rationnelle entre ces chercheureuses :

« L’objectivité de la science n’est pas une question d’individu… mais une question sociale qui résulte de leur critique mutuelle, de la division du travail amicale-hostile entre scientifiques, de leur collaboration autant que de leur rivalité. Elle dépend donc partiellement d’une série de conditions sociales et politiques qui rendent cette critique possible. »

(…)

« La question n’est donc pas simplement que l’objectivité et l’absence de jugement de valeur sont pratiquement hors de portée de l’homme de science isolé, mais que l’objectivité et l’absence de jugement de valeur sont en elles-mêmes des valeurs. … Le paradoxe disparaît entièrement de lui-même si nous remplaçons l’exigence d’absence de jugement de valeur par cette exigence selon laquelle l’une des tâches de la critique scientifique doit être de mettre à jour les confusions de valeur et de séparer les questions de valeur purement scientifiques : vérité, pertinence, simplicité, etc. des questions de valeur extra-scientifiques. » 5

C’est également la position de la philosophe des sciences féministe Helen Longino6, pour qui l’objectivité ne s’atteint pas en imaginant qu’on peut éliminer les valeurs non épistémiques du travail scientifique, mais bien en donnant la possibilité de les examiner et de les critiquer collectivement. La question n’est donc pas : « comment éduquer les scientifiques de telle façon à ce qu’iels abandonnent leurs valeurs non épistémiques », mais plutôt « comment organiser la recherche scientifique de telle façon à mieux gérer les conséquences éventuelles de ces valeurs ». Pour Longino, cela repose sur quatre critères (que je cite d’après (Elliott 2002)) :

  • Il faut des espaces pour une critique publique (publications, conférences, etc.)
  • Il faut que la critique soit prise en compte par la communauté (débats, réponses, etc.)
  • Il faut que les normes de la critique soient publiques et partagées au sein de la communauté.
  • Enfin, il faut que la capacité intellectuelle soit le seul critère de participation à une discussion génératrice de connaissances, indépendamment du genre, de la race, etc.

La question de la diversité au sein des communautés scientifiques (et plus généralement des communautés épistémiques) est également assez centrale en épistémologie sociale, avec l’idée que sous certaines conditions, plus de diversité mène à une meilleure efficacité collective7. Cette idée trouve un certain support empirique en psychologie cognitive, notamment dans les travaux portant sur le bénéfice de l’argumentation sur les capacités de raisonnement. Hugo Mercier et ses collègues, dans leur synthèse sur cette question8, mettent en avant deux conditions observées expérimentalement pour que la discussion collective améliore les performances de raisonnement : que les individus soient libres d’exprimer leur opinion réelle, et que la gamme des opinions disponibles dans le groupe soit diversifiée.

Bref, comme annoncé, nous n’avons fait qu’effleurer la surface de cette discussion, mais on espère tout de même que cela vous a donné quelques billes pour y voir un peu plus clair dans toute cette histoire. N’hésitez pas à nous écrire si cet article vous fait réagir, et d’autant plus si vous êtes un•e spécialiste de la question et que vous identifiez des bêtises ou approximations un peu trop grossières dans ce que j’ai raconté.

Juillet 2025 : le Cortecs lance sa première École douteuse !

Du 14 au 18 juillet 2025, au cœur des Alpes de Haute Provence, le Cortecs organise sa première École douteuse, une école d’été autogérée de la pensée critique. Elle a vocation à réunir une vingtaine de personnes, d’horizons différents, intéressées par divers aspects de la pensée critique, le tout dans une ambiance conviviale, inclusive et stimulante. Vous aimez réfléchir sur l’esprit critique, participer à une belle dynamique collective et couper des légumes en parlant d’épistémologie ? Vous aimerez l’École douteuse !

Le Cortecs organise l’École douteuse, sa première école d’été autogérée, interdisciplinaire et ouverte à toute personne (étudiant-e, chercheur-euse, enseignant-e, formateur-ice, animateur-ice, …) intéressée et motivée pour échanger intensément à propos de la pensée critique et de ses aspects conceptuels, pédagogiques, didactiques et socio-politiques. Le principe est de réunir pendant une semaine, du 14 au 18 juillet, dans un gîte près du lac de Serre-Ponçon, une vingtaine de personnes passionnées par l’esprit critique, le tout dans une ambiance conviviale, inclusive, autogérée (partage des tâches de vie en commun comme la cuisine, la vaisselle, l’installation technique, etc.), et favorisant la stimulation intellectuelle permanente, les échanges et les rencontres !

Vous trouverez plus de détails, des informations pratiques, le programme, ainsi que la possibilité de candidater à l’école (une dizaine de places ouvertes), ici : https://ecoledouteuse.sciencesconf.org/ .

Qu’est-ce qu’un (bon) concept ?


Je retranscris ici une petite présentation que j’ai eu l’occasion de faire à notre réunion annuelle du Cortecs qui s’est tenue dans les Alpes le week-end du 16 Août 2024. L’outillage présenté semble répondre à des questions que l’on est nombreux·ses à se poser à propos des concepts et plus généralement des catégories de base que l’on utilise pour penser le monde. Que l’on cherche à définir « la science », « l’esprit critique » ou « la démocratie », on tombe facilement dans certains pièges où on peut vite s’embourber, et ces quelques éléments peuvent peut-être nous aider à éclaircir un peu les choses.9

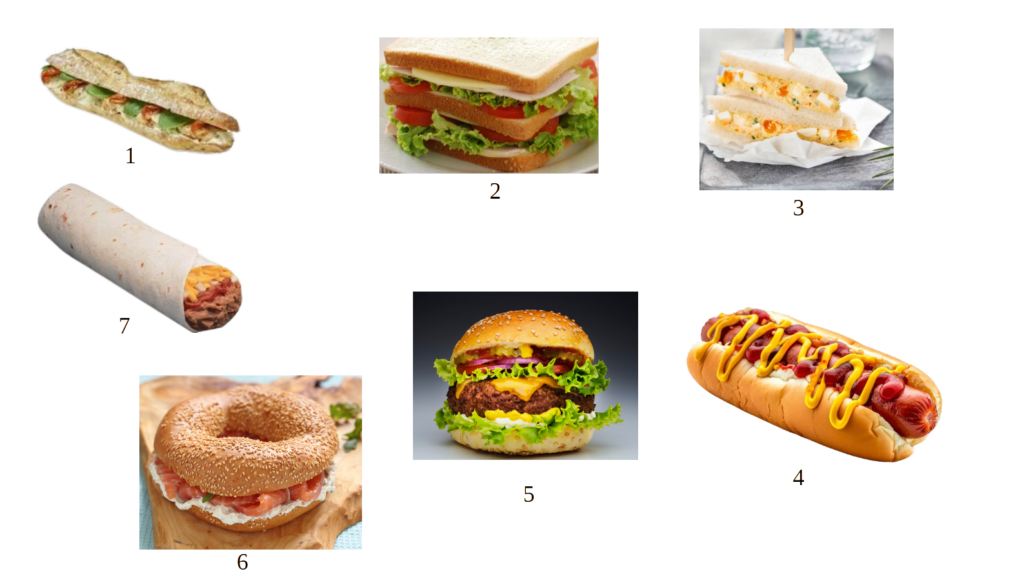
Pour commencer, posons-nous une question, fondamentale s’il en est : qu’est-ce qu’un sandwich ? Allez-y, essayez dans votre tête de produire une définition du concept de « sandwich » qui vous satisfasse. Pour vous faciliter la tâche, voici plusieurs exemples concrets : à vous de dire si, selon vous, il s’agit de sandwich ou pas.

Pour le numéro 1, normalement, tout le monde devrait tomber d’accord : si cette chose n’est pas un sandwich, alors on imagine mal ce qui pourrait être un sandwich. Le deuxième ne pose habituellement pas trop de problème non plus. En particulier, les personnes qui ont défini le sandwich comme de la garniture insérée entre deux tranches de pain le qualifieront de sandwich sans hésiter. Le numéro 3 fera plus polémique : en effet, selon la même définition, ce petit en-cas d’apéritif devrait lui aussi être un sandwich. Mais on sent que ça ne nous satisfait pas pleinement. Alors, peut-être qu’il faut rajouter, dans la définition, quelque chose à propos de la taille ? Le numéro 3 n’est pas un sandwich, mais si vous faites exactement la même chose en plus grand, cela devient un sandwich (les fameux sandwichs triangles) ? Pourquoi pas – même si on est en droit de trouver ce fait un peu étrange.

A partir du numéro 4, les choses se corsent, et c’est bien souvent ici que les gens commencent à ne plus être d’accord. Le hotdog est-il un sandwich ? Voilà une question que vous pourrez poser à vos repas de famille – et si vous en avez assez des engueulades sur fond de débats politiques sans fin, attendez de voir ce que cette question peut générer. Si non, c’est peut-être parce qu’un sandwich doit être froid pour mériter cette appellation ? Les gens sont divisés sur cette question. De la même façon, un hamburger (numéro 5) est-il un sandwich ? Si ce n’est pas le cas, il s’agit pourtant à peu près de la même idée : mettre de la garniture entre deux tranches de pain. Pourtant, on sent bien que ce n’est pas vraiment la même chose. Peut-être alors que la forme du pain est importante ? Et si jamais un hamburger est un sandwich, alors est-ce qu’un bagel (numéro 6) en est un ? Si la réponse est non, alors le simple fait de faire un trou dans le pain suffit-il à faire passer de l’état de sandwich à l’état de non-sandwich (ou inversement) ?

Finalement, et on va arrêter là, un burrito (numéro 7) est-il un sandwich ? Là, la difficulté provient du fait que la garniture n’est pas insérée entre des tranches, mais enroulée dans une galette. À part cela, vous conviendrez que l’idée fondamentale reste essentiellement identique. Pourtant, si vous en parlez autour de vous, vous verrez que le fait qu’un burrito est ou n’est pas un sandwich n’est vraiment pas une question facile à trancher (et un sandwich difficile à trancher, c’est quand même dommage).

Alors, me direz-vous, pourquoi donc parle-t-on de sandwichs ? Tout d’abord, je dois dire que j’ai piqué cette d’idée d’introduction à base de sandwichs au sociologue Gabriel Abend, que j’ai eu la chance de rencontrer à l’automne 2023 à l’Institut de Sociologie Analytique de Norrköping, lorsqu’il est venu présenter son dernier ouvrage Words and distinctions for the common good – practical reason in the logic of social science.10 Dans le premier chapitre, intitulé « sandwichness wars », il explique d’ailleurs que cet exemple, bien qu’il puisse être utilisé (comme je le fais ici) comme une introduction à la façon avec laquelle on construit, manipule ou clarifie des concepts, fait en réalité référence à un cas tout à fait concret de jurisprudence aux États-Unis.

Dans les années 2000, une chaîne de restaurants, Panera Bread, a négocié son bail dans un centre commercial, White City Shopping Center, à Shrewsbury, dans le Massachussetts, en parvenant à obtenir une clause d’exclusivité sur la vente de sandwichs : aucun autre commerce du centre commercial n’avait le droit de vendre des sandwichs à part lui. Jusqu’au jour où un restaurant mexicain, Qdoba, ouvre dans le même centre commercial et se met à vendre… des burritos. Panera Bread a alors tenté d’empêcher légalement cette ouverture en prétextant que les burritos étaient des sandwichs et donc que Qdoba et le centre commercial violaient par là les termes du contrat. Des juges ont donc du se poser très sérieusement la question : un burrito est-il un sandwich ? Bien entendu, cette question était juridiquement très difficile à résoudre, puisqu’il n’existe pas une seule définition précise de ce qu’est un sandwich, et chaque partie dans le procès pouvait exhiber la définition qui l’arrangeait – ce dont ils ne se sont d’ailleurs pas privés.

De la même manière, le procès Nix v. Hedden eut à statuer en 1893 sur la question de savoir si la tomate devait être considérée comme fruit ou légume. Résultat : la tomate est « juridiquement » un légume. Alors que c’est un fruit d’un point de vue botanique, et un légume d’un point de vue culinaire. Nous le verrons, une définition s’ancre toujours dans un point de vue et avec un certain objectif. Et si un botaniste vous invite à manger une salade de fruit, méfiez-vous !

Bref, tenter de définir et de clarifier des concepts n’est donc pas uniquement le fait de philosophes aimant à répondre à des questions abstraites que personne d’autre ne se pose, mais peut avoir des conséquences très concrètes, en orientant certaines décisions politiques ou juridiques. Les exemples du burrito ou de la tomate peuvent prêter à sourire, mais font irrésistiblement penser à un autre procès, plus grave : celui de Dover, en 2005, qui opposa des parents d’élèves à l’école publique de Dover, en Pennsylvanie.11 La raison était qu’ils accusaient cette école de vouloir enseigner, en cours de biologie, à la fois la théorie de l’évolution et l’Intelligent Design12, qu’ils identifiaient comme une forme de créationnisme savamment déguisé. Parmi toutes les questions que les juges ont du se poser, figurait donc en bonne place une question épistémologique (et conceptuelle) fondamentale : l’Intelligent Design est-il une théorie scientifique – et si non, pourquoi ? En d’autres termes, qu’est-ce qu’une théorie scientifique ?

Mise à part la différence de gravité en termes d’impact politique et social qui distingue les questions « un burrito est-il un sandwich ? », « la tomate est-elle un fruit ou un légume ? » et « l’Intelligent Design est-il une théorie scientifique ? », on comprend qu’elles sont sous-tendues par le même type de questionnements philosophiques : comment définit-on un concept ? Quelles sont les caractéristiques principales d’un concept, et comment tout ça peut nous aider à mieux nous orienter lors d’un débat ? Est-il possible de comparer plusieurs versions d’un même concept sur des bases objectives, ou tout du moins un peu moins subjectives que de simplement suivre celui qui gueule le plus fort ou a le meilleur avocat ?

Vous avez de la chance, c’est précisément ce que l’on va voir dans cet article.

Quelques caractéristiques de base des concepts

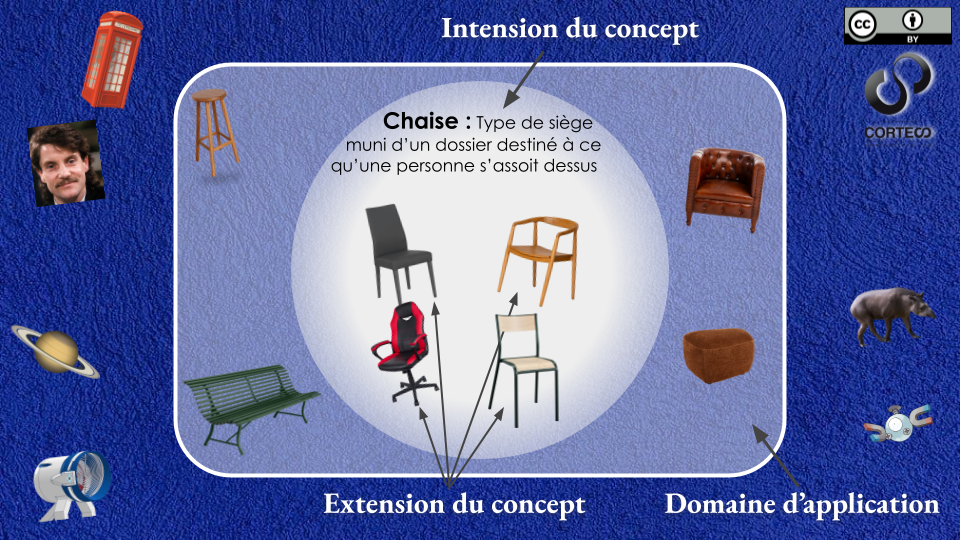
Dans cette première partie, j’aimerais présenter quatre éléments de base permettant de caractériser un concept : son domaine d’application, son extension, son intension et son but épistémique.

Le domaine d’application d’un concept donné est tout simplement l’ensemble des objets sur lesquels il est intéressant de se poser la question de s’ils correspondent positivement au concept ou pas. Par exemple, si vous cherchez à définir le concept de « chaise » (un exemple que les philosophes aiment beaucoup utiliser, avec celui de « table »), ce que vous cherchez à faire, c’est à trouver une caractérisation des objets « chaises » à l’intérieur d’un ensemble d’objets plus vaste. Pour autant, cet ensemble plus vaste ne contient pas tous les objets de l’univers, puisque pour un grand nombre d’objets, la question de s’ils sont des chaises ou non n’est pas vraiment intéressante. Il n’est pas très intéressant, par exemple, de vous demander pourquoi un chat n’est pas une chaise, alors que ça l’est beaucoup plus de vous demander pourquoi un tabouret ou un banc n’en est pas une. Pour qu’une conceptualisation, c’est-à-dire la classification d’un ensemble d’objets dans différents concepts, soit intéressante — c’est-à-dire, nous apprenne quelque chose que l’on ne savait pas — il faut que les objets que l’on souhaite classer aient quand même un minimum en commun.

L’extension d’un concept se définit alors simplement comme l’ensemble des objets qui correspondent effectivement à ce concept. L’extension du concept de « chaise » est l’ensemble des objets (le sous-ensemble du domaine d’application) qui sont effectivement des chaises. De même, l’extension du concept de « théorie scientifique » est l’ensemble des productions cognitives qui sont des théories scientifiques. Remarquez que l’on définit ici l’extension d’un concept de manière formelle : cela ne signifie pas que l’on connaît effectivement cet ensemble d’objets, que l’on y a accès dans son entièreté ou que celui-ci fasse consensus.

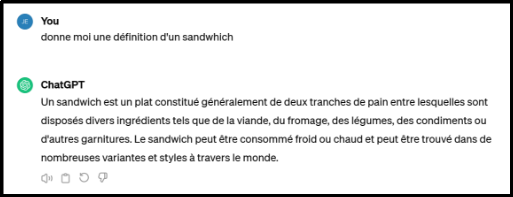
L’intension d’un concept, quand à elle, est sa définition théorique, c’est-à-dire sa caractérisation à l’aide d’autres concepts ou propriétés. Par exemple, quand j’ai demandé à chatgpt (avril 2024) de me donner une définition d’un sandwich, voici ce qu’il a répondu :

Ce qu’il m’a donné, c’est une caractérisation intensionnelle du concept de sandwich, c’est-à-dire sa définition en fonction d’un certain nombre de propriétés pouvant appartenir aux objets que l’on souhaite classer dans le concept de sandwich. Remarquez que sa définition est relativement floue, finalement, puisque dire qu’il « peut être trouvé dans de nombreuses variantes et styles à travers le monde » permet de rentrer un certain nombre d’objets que l’on aurait a priori pas mis dedans, comme les burritos.

L’intension d’un concept peut se présenter sous diverses formes. Par exemple, définir un concept peut signifier donner un ensemble de propriétés individuellement nécessaires et collectivement suffisantes que doit posséder l’objet en question pour appartenir au concept : si l’une des propriétés manque, l’objet n’est pas dans l’extension du concept, et il suffit qu’elles y soient toutes pour que l’objet soit dans l’extension du concept.

Un exemple connu : le problème de la démarcation scientifique, c’est-à-dire le problème de démarquer entre quelque chose de scientifique et quelque chose de non-scientifique, peut être vu comme un problème d’analyse conceptuelle – plus précisément, comme la recherche d’une définition intensionnelle du concept de « science » ou de « scientificité ».13

Les scientifiques, au sein de leur domaine de compétence, sont en général capables de différencier les théories scientifiques des théories pseudo-scientifiques ou non scientifiques : ils tombent d’accord sur l’extension du concept de « théorie scientifique » dans leur domaine. Par contre, demandez-leur ce qui distingue fondamentalement une théorie scientifique et une théorie non- ou pseudo-scientifique et vous les verrez avancer des propriétés censées caractériser la scientificité d’une théorie : ielles seront en train de chercher une définition en intension de ce concept, et ne seront alors peut-être pas d’accord du tout. C’est un peu la même chose que si vous présentez un ensemble d’objets sur lesquels on peut s’asseoir à des personnes, en leur demandant de vous dire lesquels sont des chaises. Même si elles tombent d’accord, ce qui n’est déjà pas gagné, demandez-leur de définir ce qu’est une chaise, l’essence de la « chaisité » : c’est là où les choses se corsent.

C’est précisément l’impossibilité d’exhiber un ensemble satisfaisant de propriétés individuellement nécessaires et collectivement suffisantes qui a poussé le philosophe Larry Laudan à déclarer au début des années 1980 que le problème de la démarcation scientifique était un pseudo-problème,14 une position qui ne fait cependant pas l’unanimité.15

Une dernière caractéristique importante d’un concept est son but (épistémique). Ingo Brigandt16 définit le but épistémique d’un concept scientifique comme l’objectif (en termes de production de connaissances, donc) qui est recherché par son utilisation.

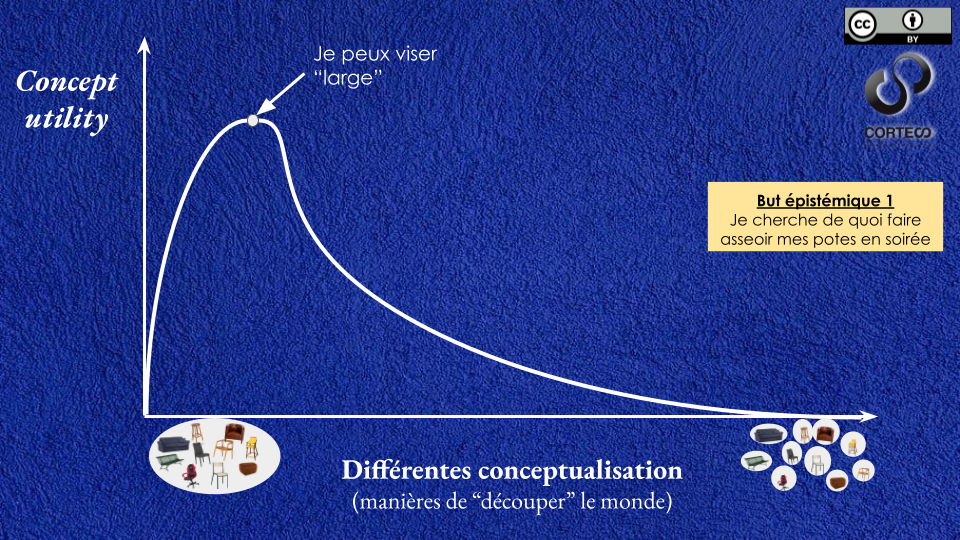
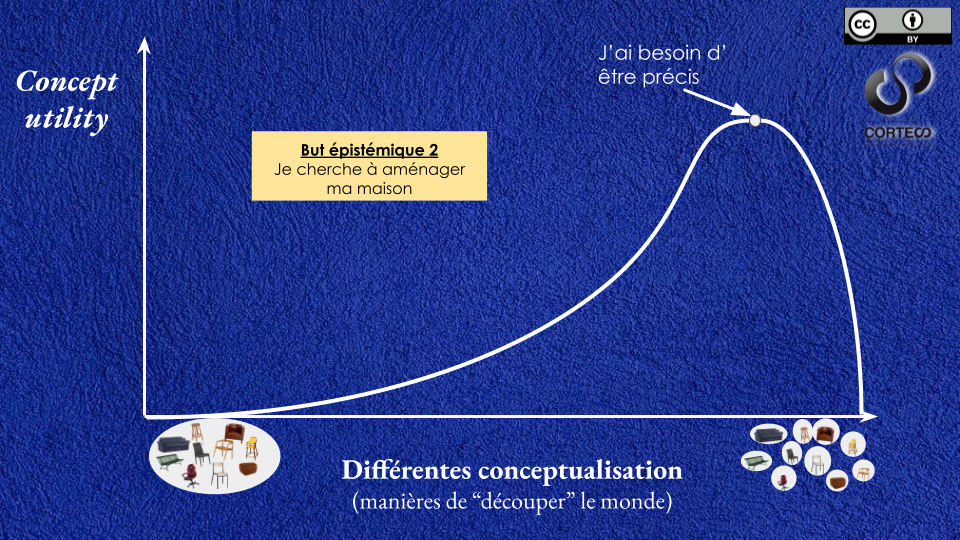
En effet, un même concept scientifique peut être utilisé dans des contextes différents et poursuivre des objectifs épistémiques différents : décrire et classifier des phénomènes ou des objets, explorer des nouvelles pistes de recherche, parler un langage commun pour communiquer avec d’autres scientifiques, et ainsi de suite. Idem pour les concepts de la vie de tous les jours (mise à part que le but n’est pas forcément épistémique) : le concept de « sandwich » utilisé par une bande d’ami.e.s qui cherche simplement quelque chose à manger peut être un peu plus lâche (et inclure des cas limites comme les burritos ou les hamburgers) que celui utilisé par un restaurant mexicain souhaitant contourner la clause d’exclusivité de la vente de sandwichs en vendant des burritos. De même, le concept de « poisson » n’est pas le même pour les biologistes que pour les poissonniers et les restaurateurs,17 non pas parce que ces différentes personnes vivent dans des réalités parallèles, mais parce que l’objectif poursuivi par l’utilisation du concept de « poisson » n’est pas le même. Les biologistes cherchent à classifier le vivant d’une façon cohérente avec la théorie de l’évolution, ce qui les a amené à éliminer le concept de poisson comme un concept pertinent (de la même façon qu’a été éliminé le concept de race humaine), alors que les poissonniers et les restaurateurs l’ont conservé, car leurs objectifs ne sont tout simplement pas les mêmes. La réalité objective est la même (les animaux que les biologistes nommaient « poissons » sont restés a priori inchangés lorsque ce concept est tombé en désuétude), mais la façon de l’appréhender, de la découper, dépend, elle, de l’objectif que l’on s’est fixé.

Ainsi, un concept peut être caractérisé par son domaine d’application, son extension, son intension et son but (épistémique ou non). Parfois, on rencontre une situation que l’on peut qualifier de pluralité conceptuelle : plusieurs versions d’un même concept co-existent mais sont utilisées différemment par différentes personnes – en gros : quand on s’engueule pour savoir ce qu’est un sandwich, une chaise, une théorie scientifique ou une espèce vivante. Dans certaines cas (mais pas toujours !) une telle situation peut être considérée comme problématique, notamment si elle s’accompagne d’une certaine confusion et d’un manque de repères communs pour travailler ensemble.

Quoiqu’il en soit, une telle pluralité conceptuelle se réduit très souvent à une différence dans le domaine d’application, l’extension, l’intension et/ou le but épistémique des concepts en question. Avoir en tête ces quatre composantes essentielles pour caractériser un concept peut donc permettre à chaque parti d’une discussion de les expliciter, ce qui peut permettre de mieux appréhender ces situations et finalement de clarifier les dissensions, afin de les rendre les plus fécondes possibles. Comme on dit : ce n’est pas grave de s’engueuler tant qu’on s’engueule pour de bonnes raisons et pas simplement parce qu’on ne parlait pas de la même chose depuis le début.

Comment évaluer une conceptualisation ?

Venons-en maintenant à la dernière question que je voudrais présenter ici : comment peut-on faire pour évaluer la pertinence d’une conceptualisation, de façon à pouvoir définir et choisir « la meilleure » parmi plusieurs possibilités ? Je définis une conceptualisation ici comme la classification d’un même ensemble d’objets en différents concepts. Par exemple, la classification des astres en planètes, planètes naines, astéroïdes, etc. ou bien celle des régimes politiques en régimes démocratiques, dictatoriaux, oligarchiques, etc.

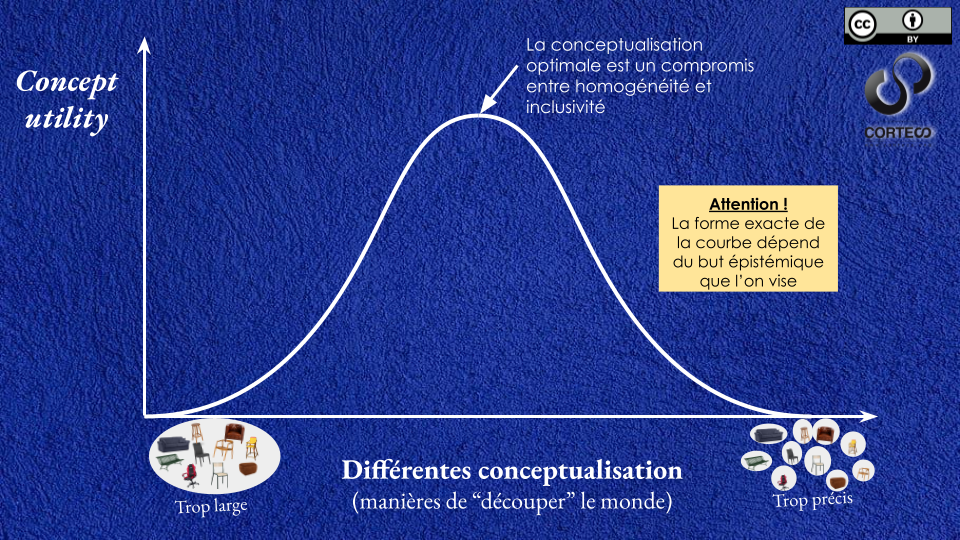
Tout d’abord, comme on l’a vu, la pertinence d’une conceptualisation est toujours adossée au but qu’elle est censée nous aider à atteindre. Ainsi, ce n’est sûrement pas possible de définir une métrique permettant d’évaluer la qualité d’une conceptualisation dans l’absolu, puisque celle-ci dépend du but poursuivi et que celui-ci n’est pas donné une fois pour toute. Cependant, il me semble que la notion de concept utility développée par Paul Egré et Cathal O Madagain18 peut nous aider à y voir plus clair dans un certain nombre de cas intéressants.

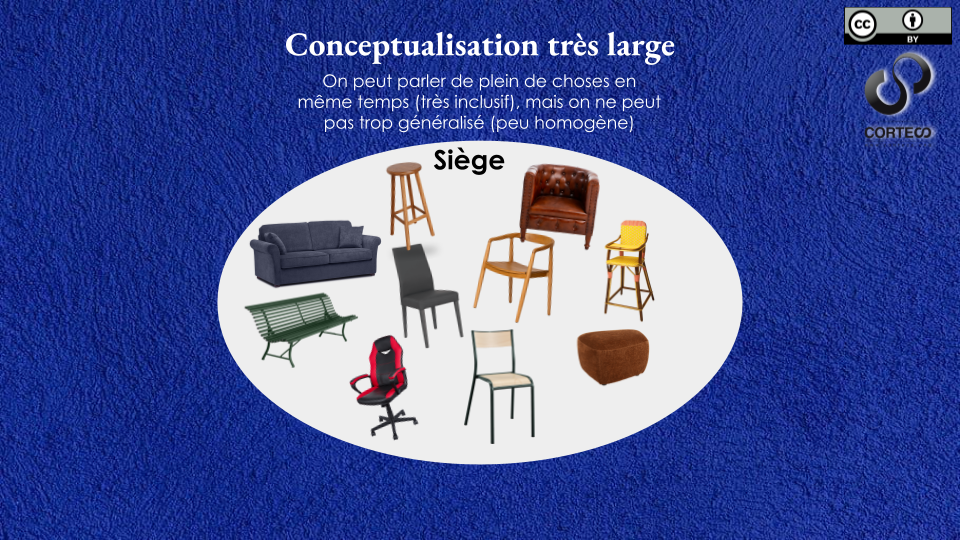
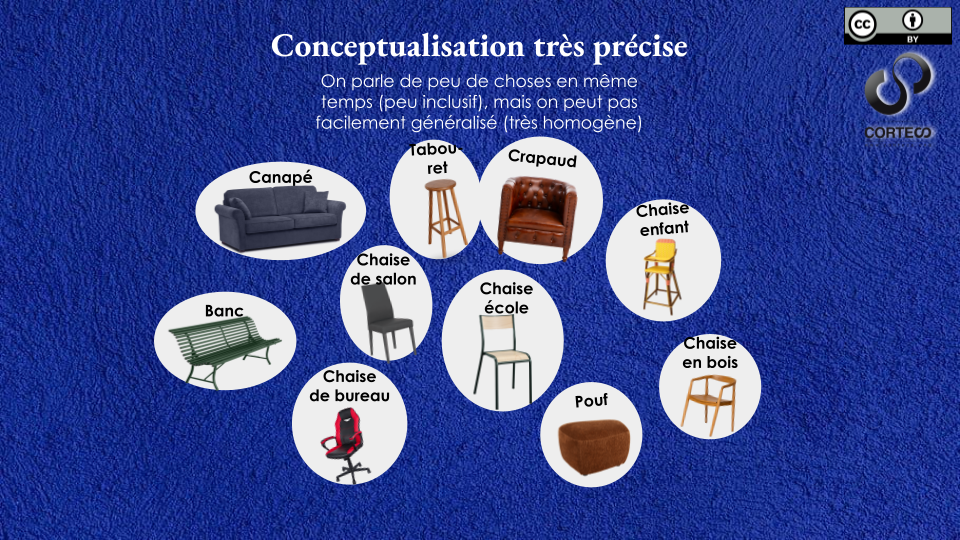
Deux qualités attendues d’un concept sont son inclusivité et son homogénéité. L’inclusivité d’un concept est le nombre d’objets que ce concept recouvre effectivement parmi l’ensemble de son domaine possible d’application : en d’autres termes, c’est la taille relative de son extension. Un concept très inclusif recouvre beaucoup d’objets, et au contraire un concept qui ne contiendrait qu’un seul objet serait le moins inclusif possible.

L’homogénéité d’un concept, quant à elle, mesure à quel point les objets à l’intérieur d’un même concept sont similaires. Une manière de définir l’homogénéité d’un concept est de calculer à quel point les objets présents dans le concept possèdent en commun un certain nombre de propriétés. Bien sûr, l’homogénéité d’un concept dépend alors directement de cet ensemble de propriétés : le concept de « poisson » recouvre un ensemble d’objets relativement homogène si on se base sur des propriétés phénotypiques ou gastronomiques, mais beaucoup moins si on se base sur d’autres propriétés, par exemple les relations phylogénétiques qu’ils entretiennent.

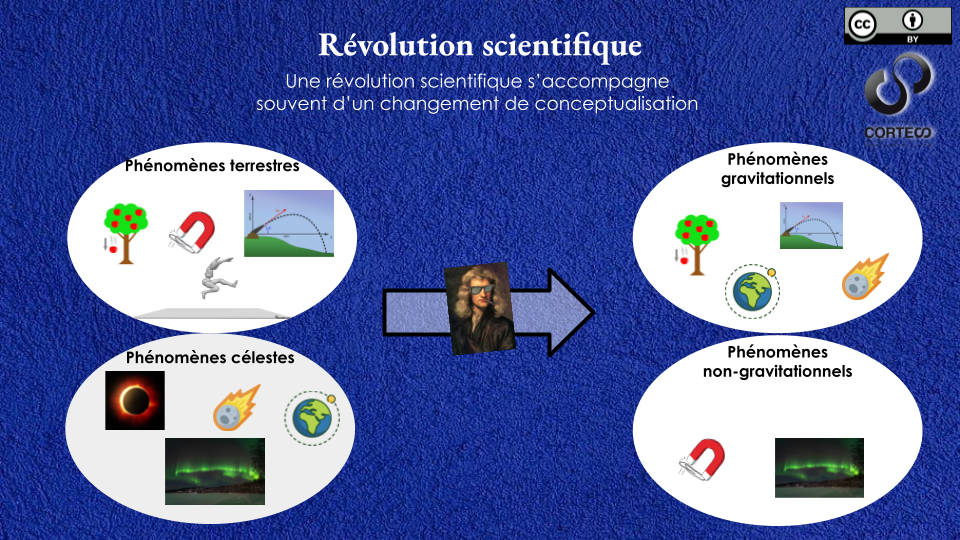
Dans l’histoire des sciences, une révolution se traduit souvent par un changement dans les propriétés pertinentes à la base des conceptualisations accompagnant les différentes théories en jeu. Par exemple, avant la mécanique newtonienne, les phénomènes célestes étaient considérés comme intrinsèquement distincts des phénomènes terrestres, avant d’être unifiés au niveau descriptif et explicatif. Les propriétés « terrestre » et « célestes » ont simplement cessé d’être pertinentes d’un point de vue de la classification des phénomènes proposée par la nouvelle théorie scientifique.

L’homogénéité est (généralement) une bonne chose, puisqu’elle permet d’inférer certaines propriétés à de nouveaux objets à partir des propriétés d’objets connus, du simple fait qu’ils appartiennent tous au même concept. Par exemple, si j’identifie un nouveau mets comme correspondant au concept de « sandwich », je pourrai inférer, sans trop risquer de me tromper, son goût, sa texture, ou tout simplement le fait qu’il va sûrement parvenir à me nourrir de manière satisfaisante.

Il se trouve que ces deux caractéristiques, inclusivité et homogénéité, bien qu’elles soient des qualités que l’on cherche à maximiser lorsqu’on construit des concepts, se retrouvent généralement en compétition l’une avec l’autre. En effet, une augmentation de l’inclusivité (on fait rentrer plus d’objets dans notre concept) mène très probablement à moins d’homogénéité (les objets sont plus nombreux mais aussi plus divers), et inversement. Une conceptualisation qui associerait un concept distinct à chaque objet serait très homogène (chaque concept contient un ensemble très homogène d’objets, puisqu’il ne contient qu’un seul objet), mais très peu inclusif – et donc, peu utile puisqu’il s’agit d’une simple reformulation de ce que l’on savait déjà. Au contraire, une conceptualisation où tous les objets d’un domaine d’application serait regroupés au sein du même concept serait très inclusive mais probablement tellement hétérogène que l’on ne pourrait rien apprendre sur un objet du fait qu’il appartient à ce concept (puisque tous les objets y appartiennent).

Une telle situation, où l’on peut définir deux qualités que l’on cherche à maximiser mais qui rentrent en concurrence l’une avec l’autre, appelle à la recherche d’un optimum. C’est précisément ce que tente de capturer la concept utility : elle est définie comme le produit de l’inclusivité et de l’homogénéité d’un concept, moyenné sur tous les concepts d’une conceptualisation donnée. Dans leur article, les auteurs définissent cette notion mathématiquement, mais l’idée se comprend bien même sans son formalisme : une fois donné un ensemble d’objets que l’on cherche à classer, et un ensemble de propriétés que l’on peut mesurer sur ces objets, la meilleure conceptualisation (le meilleur découpage de ces objets en un nombre donné de concepts) est celle qui est optimale du point de vue à la fois de l’inclusivité et de l’homogénéité de ses différents concepts – par définition, celle qui maximise la concept utility.

Les conceptualisations sous-optimales, au sens de la concept utility, seraient celles qui favoriseraient une qualité au détriment de l’autre. Le concept de « nature » ou « naturel », par exemple, se retrouve souvent être trop inclusif, recouvrant par là des choses si hétérogènes que rien ne peut être inféré à leur propos du seul fait qu’elles appartiennent à ce concept. Par exemple, des substances « naturelles » sont dangereuses pour l’humain, quand autant d’autres lui sont bénéfiques : impossible, avec ce concept de « substance naturelle » de savoir si une telle substance donnée va être bénéfique ou pas. Mais encore une fois, la pertinence d’un concept dépend aussi de ce que l’on souhaite en faire, c’est-à-dire du contexte de son utilisation. Si on veut faire des inférences à propos de la dangerosité d’une substance, le fait qu’elle soit « naturelle » ou pas ne nous apportera pas d’information, puisque le concept de « naturel » tel qu’il est entendu dans ce contexte est en réalité trop inclusif et trop hétérogène pour cela. Par contre, s’il s’agit d’inviter vos ami.e.s à aller vous balader « dans la nature » pour le week-end, dans le cas ce concept peut très bien être tout à faire opérant.

Conclusion

Voilà donc un ensemble de caractéristiques importantes des concepts et des conceptualisations qu’il me semblait intéressant de partager. Je vous invite chaleureusement à tenter d’appliquer ce cadre d’analyse aux exemples de concepts ou de catégories, scientifiques ou pas, qui vous touchent de plus près — je suis certain qu’il y en a !

Il y aurait encore d’autres questions à se poser à propos des concepts. Par exemple, comment les opérationnaliser efficacement ? C’est-à-dire, comment passer d’une définition théorique et générale à une manière concrète de les traduire en propriétés, grandeurs et variables mesurables ? L’opérationnalisation d’un concept, bien qu’elle ne soit jamais univoque, est indispensable lorsque l’on veut tester des hypothèses et des modèles portant sur le monde réel et ne pas en rester à un simple jeu intellectuel théorique. Une autre question intéressante pourrait être celle de la réaction à adopter face à une pluralité conceptuelle, lorsque différentes versions d’un même concept co-existent. Comme je l’ai évoqué plus haut, cela peut, dans certains cas, mener à des situations intellectuellement insatisfaisantes, comme par exemple à une confusion conceptuelle ou à une impossibilité pour des scientifiques de se comprendre et de débattre au sein d’un cadre commun.

Nous pourrons éventuellement y revenir dans un prochain article.

« Pilules roses – De l’ignorance en médecine » de Juliette Ferry-Danini (Note de lecture)

Avec « Pilules roses », la philosophe de la médecine Juliette Ferry-Danini nous livre son enquête édifiante sur un scandale entourant le Spasfon, et plus généralement le phloroglucinol, sa molécule active. Faisant partie des médicaments les plus prescrits et vendus (principalement) en France, et en majorité à des femmes, il se trouve qu’il n’a pourtant jamais fait la preuve de son efficacité selon les critères méthodologiques qui sous-tendent de nos jours la mise sur le marché d’un produit de santé. Les origines de cette situation d’ignorance ainsi que les conditions de son maintien dans le temps sont multiples, mais mettent au jour des défaillances tout autant épistémologiques qu’éthiques, le tout profondément imprégné d’un sexisme systémique dont l’institution médicale, des essais cliniques eux-mêmes jusqu’aux professionnels de santé en passant par les campagnes de publicité de l’industrie pharmaceutique, constitue la courroie de transmission.

L’ouvrage débute avec une image très parlante et pédagogiquement puissante de la façon avec laquelle les différents types de connaissances et de pratiques en médecine s’encapsulent les unes dans les autres : des boites gigognes, à l’intérieur desquelles s’entremêlent à la fois des questions épistémologiques (qui ont trait aux connaissances et à leur justification) et des questions éthiques (qui ont trait à ce qu’il convient moralement de faire). La boite qui contient toutes les autres, la plus visible, représente la façon avec laquelle le ou la professionnel-le de santé va informer son ou sa patient-e pour mener à une décision de santé éclairée. Elle dissimule toutes les autres boites, non moins importantes. D’abord, comment un-e professionnel-le de santé s’informe sur les différents médicaments à disposition et sur les données soutenant (ou pas) leur efficacité. Puis, comment ces données sont elles-mêmes produites. Cette dernière question en renferme deux autres : comment mener des essais cliniques sans produire de souffrance inutile et, finalement, à quelle méthodologie un essai clinique doit-il se plier, et pourquoi. Cette vision en boites gigognes donne sa structure à l’ouvrage, où chaque question est abordée l’une après l’autre. En plus d’être une étude de cas à propos du scandale entourant le Spasfon, il constitue donc également une très riche introduction à des questions plus générales concernant l’institution biomédicale dans son ensemble, du laboratoire de recherche au cabinet de consultation. Dans cet article, nous en présentons de manière très résumée certains aspects en particulier, mais le but étant de vous donner envie d’aller lire le livre, sachez que nous sommes loin d’être exhaustifs.

L’origine du problème

Tester un médicament, ça coûte de l’argent et ça prend du temps, deux éléments qui étaient pourtant à disposition (et plus qu’il n’en faut) des différentes entreprises qui ont commercialisé le Spasfon depuis sa mise sur le marché. En effet, commercialisé depuis les années 60, il est rapidement devenu un énorme succès industriel. C’est à mettre en rapport avec le nombre extrêmement faible d’études cliniques produites depuis plus d’un demi-siècle – sans parler de celles, encore plus rares, qui respectent une méthodologie un tant soit peu rigoureuse. Il semble qu’au moment de sa mise sur le marché, le médicament n’avait été testé que sur une poignée de personnes, dont une majorité de femmes, et qu’il ait profité d’un certain laxisme, probablement parce que les pathologies qu’il était censé traiter étaient dès le départ considérées comme principalement féminines. A cette époque, les contraintes pour mettre sur le marché un médicament étaient certes moins fortes qu’aujourd’hui mais, d’une part, cela n’a jamais été régularisé par la suite alors que des essais cliniques auraient pu être réalisés – et auraient du être exigés de la part des autorités – et, d’autre part, certaines expérimentations (où il s’agissait, en particulier, de provoquer volontairement des douleurs) ont été pratiquées alors qu’elles violaient des principes éthiques fondamentaux, même pour l’époque. La philosophe se fait alors historienne et met au jour des archives de l’époque pour appuyer son propos de manière convaincante.

Les mécanismes de maintien de l’ignorance

Pour comprendre comment une telle situation d’ignorance caractérisée a pu émerger et surtout se maintenir aussi longtemps, différents éléments sont à prendre en compte. En plus des essais cliniques déjà peu convaincants, d’autres études censées appuyer l’efficacité du Spasfon portaient en réalité uniquement sur des mécanismes biologiques (perçus comme) plausibles, ce qui constitue un niveau de preuve très faible en regard des standard actuels, loin derrière les essais contrôlés randomisés et les méta-analyses, par exemple – d’autant plus que certains de ces mécanismes étaient supposés agir sur les « spasmes » et les calmer, phénomènes dont l’existence même est très controversée. En réalité, comme le souligne l’autrice, il ne s’agirait probablement que d’un mythe comme il en existe d’autres autour du fonctionnement physiologique féminin, rappelant par exemple la fameuse « hystérie » psychanalytique, et dont une conséquence importante est la minimisation des ressentis – et en particulier de la douleur – des femmes. Un problème reposant sur un mythe, donc, ainsi qu’une solution toute trouvée pour le résoudre, toute aussi mythique mais qui peut pourtant convaincre par sa simplicité.

On voit un biais sexiste à l’œuvre déjà à au moins deux endroits ici : dans le laxisme concernant les conditions de la mise sur le marché d’un médicament censé prévenir ou soulager des maux perçus comme principalement féminins, et dans les conditions même de justification de l’efficacité d’un traitement, quand bien même celle-ci repose déjà sur des bases très fragiles. Mais ce n’est pas fini. Il reste également à expliquer comment le succès du Spasfon a pu se maintenir dans le temps en dépit de son inefficacité probable – il est également affaire de discriminations et de présupposés sexistes ici. Imaginez que vous vouliez faire de votre médicament un succès commercial. Une fois qu’il est mis sur le marché, vous pouvez faire de la publicité pour convaincre directement les patients et les patientes de son efficacité, mais c’est long, coûteux, sans certitude que cela soit vraiment efficace. Vous pouvez aussi, et c’est la stratégie que l’autrice s’attache à décrire ici, concentrer vos efforts sur les professionnel-les de santé, par exemple en payant très cher le fameux « office de vulgarisation pharmaceutique » pour faire inscrire votre médicament dans le dictionnaire pharmacologique de référence (en France) : le Vidal, ou bien pour qu’il fasse votre publicité directement auprès des professionnel-les de santé. (Ici, nul besoin de supposer un quelconque lavage de cerveau : simplement contrôler l’information disponible et la façon avec laquelle on la perçoit est beaucoup plus efficace.) Ensuite, une fois que celleux-ci sont enclin-es à prescrire votre médicament en masse, le fait qu’en général les patients et patientes font confiance aux professionnel-les de santé qu’ils et elles consultent fera le reste. De plus, concernant les traitements visant à soulager la douleur chez les femmes, le fait que les professionnel-les de santé ont tendance à minimiser systématiquement celle-ci permettra également de protéger votre médicament de la réfutation de son efficacité : si la patiente n’a plus mal, c’est bien la preuve que votre médicament est efficace ; si elle a encore mal, c’est probablement « psychologique », ou dû au fait que « les femmes ont tendance à exagérer leur douleur », rien à voir avec l’inefficacité de votre médicament. Ainsi, le risque est minime qu’on cherche à le remettre en question en produisant, par exemple, de nouvelles études cliniques. L’ignorance à la base du problème se reproduit donc d’elle-même – et le tout s’auto-entretient.

Il faut bien sûr prendre ceci pour ce que c’est : un modèle, forcément simplifié, d’un mécanisme possible de reproduction des discriminations expliquant le maintien dans le temps d’un tel produit de santé sans efficacité propre. Pour autant, il capture déjà des aspects essentiels du processus. Pour une vision plus fouillée et complète, nous vous invitons bien sûr à lire l’ouvrage.

Secret de Polichinelle et éthique du placebo

Finalement, il apparaît que l’inefficacité du Spasfon serait plus ou moins un secret de polichinelle chez les professionnel-les de santé. Comme montré dans le livre, beaucoup le savent très bien ou du moins s’en doutent fort, et pourtant continuent de le prescrire. Nul besoin de supposer qu’iels sont payé-es directement par l’industrie pharmaceutique pour ça : encore une fois, l’inertie de l’habitude couplée d’une rationalisation du type « les patientes sont habituées » ou « dans tous les cas on peut jouer sur l’effet placebo, ce qui ne fait jamais de mal », suffit à expliquer cette situation. Et justement, c’est sur ce dernier point – l’utilisation des placebos en médecine – que l’autrice clôture son ouvrage. Elle se prononce en effet en défaveur de leur utilisation, pour plusieurs raisons en accord à la fois avec les recommandations issues des meilleures méta-analyses sur les effets supposés de l’administration d’un placebo et sur des travaux fondamentaux en éthique du biomédical, dont elle est d’ailleurs spécialiste. Allant à l’encontre d’une idée reçue (qui semble intuitive de prime abord) souvent entendue en défense des traitements qui n’ont pas fait la preuve de leur efficacité spécifique, elle montre que non, l’administration d’un placebo n’est pas (toujours) sans danger. D’une part, il peut y avoir des effets directs de l’administration d’un placebo, notamment lorsque celui-ci est « impur » – c’est-à-dire qu’il y a un principe actif, c’est juste qu’on a de bonnes raisons de penser que ce principe n’agit pas sur la pathologie que l’on veut traiter. Quant aux placebos purs (qui ne contiennent aucun principe actif), les meilleures études sur le sujet montrent que l’effet placebo a été surestimé pendant des décennies, et qu’en réalité, quand il existe, il est assez faible, trop faible pour apporter un bénéfice thérapeutique substantiel – vous ne pouvez pas guérir grâce à un placebo, mais son administration couplée à certains éléments de contexte thérapeutique peut avoir un effet sur certains de vos symptômes, comme par exemple la douleur. Mais d’autre part, il y a aussi des effets indirects : certains médicaments prescrits comme « placebo » peuvent être achetés sans ordonnance, et donc la croyance dans leur efficacité peut mener à de l’automédication, éloigner les personnes de traitements efficaces et donc diminuer leurs chances d’être soignées correctement. De plus, du point de vue éthique, administrer un placebo à un ou une patient-e à son insu c’est aller contre leur consentement, puisqu’iels ne sont alors pas en mesure de prendre une décision éclairée. De nouveau, nous vous invitons à lire l’ouvrage pour une présentation bien plus riche et détaillée des raisonnements sous-jacents à cette discussion.

Conclusion

Puisant à la fois dans l’épistémologie, la philosophie, l’éthique, l’histoire et la sociologie de la médecine, l’ouvrage de Juliette Ferry-Danini apparaît donc incontournable pour toute personne désireuse d’aiguiser son esprit critique sur la production, la diffusion et l’application des connaissances en médecine. Celles-ci, d’un point de vue féministe, ne semblent pas pouvoir se départir de leurs conditions sociales et culturelles d’émergence où les logiques patriarcales et mercantiles, comme souvent, vont de pair dans la production et le maintien d’une ignorance stratégique.

Peut-on modéliser le monde social ?

Suite à ma conférence donnée le samedi 26 mars 2022 à Bruxelles au skeptics in the pub organisé par le comité para, je reviens dans cet article sur quelques points, dans le but de préciser certaines choses en complément de mon intervention. On va (re)parler de modèles en sciences et en sciences sociales tout particulièrement, en prenant comme exemple le modèle de ségrégation urbaine dû à Thomas Schelling. Ensuite, je reviendrai sur des remarques et des questions qui ont été soumises lors de mon intervention et auxquelles je n’ai pas apporté, à mon goût, de réponse satisfaisante. Il est conseillé de visionner la conférence dans un premier temps afin d’avoir à l’esprit l’entièreté du contexte de la discussion, et en particulier l’ensemble des sources sur lesquelles je m’appuie et que je ne recite pas en détail ici.

Modéliser le social

Le but de ma conférence était de présenter certains contre-exemples à opposer à des arguments souvent entendus pour soutenir le fait que les sciences sociales, et la sociologie en particulier, doivent jouir d’une épistémologie à part. Elles seraient, dans leur essence même, différentes des sciences dites « naturelles » à tel point que les critères épistémologiques habituellement appliqués à ces dernières, par exemple le fameux falsicationnisme poppérien, ne pourraient avoir prise ou de pertinence à l’égard de leur scientificité.

Je ne reviens pas sur ces questions que j’ai déjà exposées un peu plus en détail dans mon intervention. D’autres articles s’y sont d’ailleurs attelés ici-même. Ce qui m’intéresse ici, c’est de revenir sur un des modèles que j’y ai présenté, à savoir le modèle de Thomas Schelling ayant pour but de modéliser certains aspects des processus de ségrégation urbaine.

Le modèle de Schelling

Ce modèle, hautement stylisé, considère un processus dynamique prenant place sur un quadrillage. Sur ce quadrillage, on considère des agents de deux types représentés par deux couleurs (par exemple, rouge et bleu) disposés initialement sans ordre précis, et laissant un certain nombre de cases vacantes. On encode ensuite une dynamique où, à chaque pas de temps, les agents rouges et bleus peuvent changer de place en suivant une règle extrêmement simple. Chaque agent a huit plus proches voisins que l’on appelle son voisinage, ou quartier. On considère que les agents d’une couleur donnée ont un certain degré de tolérance envers les agents de l’autre couleur : chaque agent accepte que son voisinage soit constitué d’un certain pourcentage d’agents d’autres couleurs. Si ce pourcentage est supérieur au seuil de tolérance, alors l’agent « déménage », c’est-à-dire prend, sur le quadrillage, la place vacante la plus proche qui le satisfait de nouveau. Or, en ayant déménagé, il a légérement changé le quartier d’où il est parti tout autant que le quartier où il est arrivé, ce qui a pour conséquence de modifier l’état dans lequel se trouvent les occupants de ce quartier : le seuil de tolérance de certains agents présents dans ces quartiers a peut-être été dépassé. S’en suit une réaction en chaine.

Simulation avec un seuil de tolérance de 50%.
(Crédit : https://github.com/b3rnoulli/schelling-segregation-model)

En simulant cette dynamique pour un grand nombre de pas de temps, on observe la chose suivante : même avec un seuil de tolérance relativement élevé, par exemple 70% (ce qui signifie que chaque agent accepte d’être entouré jusqu’à 70% d’agents de l’autre couleur), en partant d’une situation où tous les agents sont disposés au hasard, on obtient inéluctablement une forte ségrégation. Ce qui veut dire que, selon ce modèle, même des individus assez tolérants peuvent, sans même s’en rendre compte, prendre des décisions individuelles qui, une fois agrégées les unes avec les autres, finissent par produire une forte ségrégation au niveau macro-social. D’autre part, on observe aussi que si le seuil de tolérance est très bas, donc si on a des individus très peu tolérants, alors on obtient une situation assez instable où la ségrégation est, paradoxalement, très faible : les individus qui arrivent quelque part sont si peu tolérants qu’ils déménagent rapidement, avant qu’ait pu se former un voisinage leur ressemblant assez pour qu’ils restent.

Si vous êtes intéressés, vous pouvez faire jouer vous-même la simulation via ce site : https://ncase.me/polygons/ et tester plusieurs configurations et paramétrages de départ.

Un peu d’épistémologie des modèles

Ce modèle, comme tous les modèles, est stylisé à l’extrême et repose sur des hypothèses loin de recouvrir l’ensemble des réalités dont on a connaissance au sujet des phénomènes de ségrégation. Par exemple, les seuls facteurs intervenant dans la dynamique du processus sont les décisions des individus qui habitent la ville, réduits à des couleurs dans une case, et ne reposant que sur un choix binaire (rester/déménager) commandé par un seuil de tolérance. Beaucoup d’aspects, comme les politiques publiques en termes d’aménagement, parfois elles-mêmes ségrégationnistes, le marché de l’immobilier ou encore les décisions des propriétaires (parfois eux-mêmes racistes) ne sont pas implémentées dans ce modèle. En gardant en tête ces limites – et tout modèle, de la physique quantique à la génétique des populations, a ses limites – le modèle de Schelling nous dit-il tout de même quelque chose d’intéressant ?

Un modèle est une représentation simplifiée de la réalité et ce que l’on perd en détail, on le gagne en manipulabilité. En d’autres termes, il y a une sorte d’équilibre entre, d’une part, un niveau de détails que l’on veut atteindre, et d’autre part la facilité avec laquelle on peut le manipuler et donc lui faire dire des choses. Pensez à une carte géographique : si la carte est trop complexe, par exemple si c’est la carte d’une région et qu’elle représente chaque rue de toutes les villes de la région, cette complexité va empiéter sur ce que l’on va pouvoir faire de la carte, c’est-à-dire sur l’aide cognitive qu’elle va nous apporter pour nous repérer. Si elle est trop simple, alors elle sera plus facilement manipulable, mais, bien sûr, on pourra faire moins de choses avec. Par exemple, on saura que telle ville est au dessus de telle autre et qu’il faut prendre cette route pour les relier, par contre une fois arrivée dans la ville il faudra utiliser une autre source d’information pour trouver, par exemple, la meilleure pizzéria. Dans tous les cas, même si elle est très simple, l’important est qu’elle parvienne à capturer un certain aspect du monde et de ses mécanismes. L’équilibre à trouver entre complexité et manipulabilité dépend entièrement de ce que l’on veut faire avec ce modèle, c’est-à-dire quel aspect du monde on souhaite qu’il nous rende intelligible – et jusqu’à quelle précision. On sait que les hypothèses sur lesquelles il repose sont parcelaires et manquent de nombreux détails qui pour d’autres raisons sont extrêmement importants à prendre en compte, et une erreur serait de tomber, en physique comme en sociologie, dans un réalisme naïf qui nous fait directement prendre nos modèles pour ce à quoi ressemble la réalité que l’on tente d’approcher.

Pour revenir au modèle de Schelling, ce qui intéressant est que, justement, même dans le cas où des hypothèses pouvant expliquer plus directement la ségrégation (comme par exemple le racisme de certains propriétaires) ne sont pas prises en compte et qu’au niveau micro-social les agents seraient d’accord pour qu’il n’y ait pas de ségrégation, une ségrégation apparaît inéluctablement. Ce qu’il nous montre, ce n’est évidemment pas la réalité dans toute sa complexité – car, en fait, aucun modèle ne fait une telle chose. Utiliser ce modèle et en parler, ce n’est pas non plus nier que d’autres facteurs jouent également dans le phénomène de ségrégation – à moins d’être d’une extrême naïveté épistémologique ou bien de vouloir faire dire à ce modèle des choses qu’il ne dit pas, dans le but, par exemple, de minimiser des politiques racistes. Non, modéliser la ségrégation avec le modèle de Schelling, c’est simplement analyser le problème comme une composition de plusieurs phénomènes conjugués et extraire l’un de ces phénomènes supposés pour le modéliser à part. En regardant ce que ce simple phénomène produirait comme effet – ici un effet dit « pervers » où le résultat macro-social va à l’encontre des opinions ou des attentes micro-sociales – il nous apporte une information importante. Au niveau méthodologique, un modèle n’est ni plus ni moins qu’un guide cognitif, des planches en bois posées sur le sable mouvant de la réalité pour nous aider à la regarder de plus près.19

Notons que ce modèle possède par ailleurs un certain succès empirique, puisqu’aux États-Unis où la ségrégation raciale a été très étudiée, il apparaît que le niveau de tolérance au niveau individuel augmente au cours du temps alors qu’une ségrégation urbaine élévée se maintient encore aujourd’hui.

Pour plus d’informations à ce sujet, je ne peux que vous conseiller ce cours en vidéo (en anglais) du sociologue Thomas Grund sur la ségrégation en général et sur le modèle de Schelling en particulier. https://www.youtube.com/watch?v=me9DBTsmUgo

Ce type de modèles et d’approches du monde social se reconnaît sous le vocable de « sociologie analytique », un ensemble de programmes de recherche assez peu connus en France – où la sociologie repose plus traditionnellement sur une approche holiste. Notons que le processus d’idéalisation en sociologie n’est absolument pas nouveau puisque la notion de type idéal, qui recouvre bien cette idée de décrire une réalité complexe en en stylisant à l’extrême certains aspects, remonte à Max Weber (1920). 20

Ce n’est pas de la sociologie

Je voudrais maintenant aborder un type de commentaires que l’on m’a adressé pendant la conférence et auquel je voudrais donner ici une réponse un peu plus claire. Ce type de commentaires, le voici :

« C’est sympa, mais ce n’est pas de la sociologie ».

J’ai présenté dans ma conférence un exemple de résultat typique de l’approche mécanistique propre à la sociologie analytique : on parvient à reproduire une régularité empirique portant sur la distribution des votes lors d’élections proportionnelles dans de nombreux pays différents et à différentes époques – ce qui est déjà en soi un résultat intéressant – en modélisant simplement l’influence sociale de proche en proche à l’aide d’un modèle en réseaux. À chaque nœud du réseau, représentant un individu, l’influence qu’il peut avoir sur les personnes avec qui il est en contact est modélisée par une certaine probabilité de les convaincre de voter pour tel ou tel candidat. En mettant la bonne distribution de probabilité (de forme classique pour ce type de phénomènes), on reproduit effectivement la distribution finale des votes observée macroscopiquement.

On m’a fait la remarque que ce n’était pas de la sociologie, mais de la théorie des réseaux – c’est-à-dire un simple modèle mathématique. Or, certains éléments de ce modèle possèdent une signification empirique, c’est-à-dire font référence à des grandeurs mesurables. Certes, le phénomène est expliqué au sein d’un cadre où l’on a accepté de manière a priori certaines hypothèses – et en particulier la forme de la probabilité modélisant l’influence sociale de proche en proche sur le réseau. Une explication plus « profonde » consisterait à dériver cette hypothèse à partir d’autres hypothèses appartenant à la sociologie ou à la psychologie cognitive, par exemple. Mais ça n’en reste pas moins une explication sociologique puisqu’en supposant cela, on redérive de manière non triviale une observation empirique portant sur le monde social. On pourrait faire le parallèle avec les modèles en mécanique newtonienne : on modélise un phénomène à l’aide d’un ensemble de forces qui s’exercent sur un système, mais la forme même de ces forces n’est adoptée que parcequ’elles parviennent ainsi à redériver un certain nombre d’observations empiriques. Pour autant, ils restent des modèles explicatifs – c’est simplement que l’explication est adossée à un certain cadre que l’on doit se donner a priori, contenu dans ce que Imre Lakatos appelait le noyau dur des théories. Le modèle cité plus haut n’est donc pas un simple modèle de la théorie des réseaux, mais le modèle d’un phénomène social, puisqu’il contient des éléments qui ont une signification empirique et qui portent sur le monde social (ici, le nombre de votes qu’un candidat obtient, le nombre de candidats dans sa liste, etc.) De la même façon, par exemple, que la théorie de la relativité générale n’est pas simplement de la géométrie lorenztienne (le cadre mathématique dans lequel cette théorie est écrite) puisqu’elle contient des hypothèses de correspondance entre des éléments de ses modèles et des éléments observables empiriquement.

Il se trouve que l’on peut dériver certains résultats empiriques portant sur un aspect du monde social sans faire référence – ou alors d’une manière minimale – aux intentions des individus prenant part au processus. Si on regarde la taille des villes en fonction de leur rang, par exemple au sein d’un pays, on tombe quasiment à chaque fois sur la même distribution (dite « en loi de puissance ») qui est typique des phénomènes d’agrégation asymétriques (où des choses s’agrègent et ont plus de probabilité de s’agréger là où quelque chose est déjà agrégé). On retrouve la même distribution pour d’autres phénomènes qui ne sont pas sociaux, comme par exemple les amas d’étoiles. Il est assez étonnant qu’un phénomène comme l’expansion d’une ville, qui en soit fait intervenir un nombre incalculables d’intentions et d’intérêts conflictuels, mais aussi des facteurs non humains, etc. finissent par produire une telle régularité. On m’a alors rétorqué que si un modèle pouvait reproduire un phénomène social sans qu’il n’y ait rien d’humain dedans, c’est-à-dire qui marche même « si c’est pas des humains », alors ce n’était pas de la sociologie.

Il y a deux réponses à apporter ici. Premièrement, le comportement humain est, comme tout le reste, modélisé au sein d’une théorie de l’action servant de support à une explication basée sur l’exhibition de mécanismes microsociaux qui, une fois agrégés, reproduise le phénomène macro-social à expliquer. Il faut, très souvent, modéliser l’action humaine pour que le mécanisme explicatif puisse s’incarner. Certes, cette modélisation est souvent stylisée pour pouvoir être facilement manipulable au sein de modèles, mais il n’en reste pas moins qu’elle existe et est souvent nécessaire (mais parfois, non!) On modélise l’action humaine jusqu’à la finesse nécessaire pour reproduire ce que l’on cherche à reproduire – de la même façon que modéliser une planète comme un point matériel qui ne subit que la force du soleil est une approche très stylisée et qui repose sur des hypothèses que l’on sait, en quelque sorte, fausses, mais cela permet néanmoins de reproduire de manière non triviale un certain nombre d’observations.

Deuxièmement, cet argument, me semble-t-il, dissimule une circularité dans le raisonnement. Devant le constat que l’on peut modéliser certains phénomènes sociaux à l’aide d’une théorie de l’action on ne peut plus minimaliste, dire que ce n’est pas de la sociologie c’est déjà faire le présupposé d’à quoi doivent ressembler les explications en sociologie, donc cela ne permet pas d’écarter logiquement ce type d’explications (à base de modèles) puisque c’est la prémisse de laquelle ce raisonnement démarre. Si on part du principe que les explications en sociologie ne peuvent pas reposer sur des mécanismes fondés sur des modélisations stylisées de l’action inviduelle, alors face aux inombrables contre-exemples offerts par la sociologie analytique, on ne peut sortir de la circularité qu’en remettant en question ce principe. En effet, peut-être que les phénomènes sociaux, malgré la grande complexité avec laquelle ils peuvent nous apparaître, sont, dans certains de leurs aspects, modélisables bien plus simplement que ce que l’on croyait. C’est bien l’une des caractéristiques de la science de nous être parfois si subversive en ce qu’elle bouscule nos a priori et certainement nos croyances à propos de notre caractère si spécial en tant qu’humain et du fait que le social ne saurait être – même en partie – dompté par aucun modèle.

Conclusion : tout est modèle

Pour conclure, je pense qu’en fait même si on n’utilise pas de modèle aussi stylisé que ce qu’on a présenté, qu’on ne cherche pas à généraliser, qu’on en reste à aller voir en détail ce qui se passe sur le terrain, et que notre but est de décrire aussi précisément que possible ce qu’il s’y joue, il n’en reste pas moins qu’on est toujours en train… de faire un modèle. En effet, malgré le fait que nous sommes des êtres sociaux et que de ce fait le ou la sociologue peut interagir dans un langage naturel avec les sujets de son étude, il n’en reste pas moins que cette interaction est toute sauf « directe ». En effet, outre que la présence de l’ethnologue modifie l’objet même de sa recherche et qu’il existe un grand nombre de biais possibles bien connus de la profession, décrire une situation c’est déjà la styliser inmanquablement. Tout simplement parce que les mots que nous utilisons réfèrent à des catégories proprement humaines et à des concepts qui ne sont rien d’autres que des généralisations – par définition – idéaliséees. Un concept est déjà modélisateur. Une enquête de terrain, nécessaire à la connaissance sociologique, c’est déjà le modèle de quelque chose. On a déjà tranché dans la réalité sociale, on l’a déjà immanquablement simplifiée. On ne peut à aucun moment la connaître qu’à travers le cadre conceptuel que l’on se donne.

On ne peut donc récuser une approche basée sur des modèles (au sens de la sociologie analytique) sur le seul principe qu’ils simplifient la réalité, puisqu’il semble proprement impossible de faire autrement. Bien sûr, on peut montrer qu’ils la simplifient trop. Cela ne peut néanmoins pas reposer sur nos a priori d’à quoi elle devrait ressembler, puisque c’est justement nos modèles qui peuvent nous le dire en dernière instance ! Non, le seul juge reste la confrontation avec les données empiriques et les autres modèles concurrents. Cela et uniquement cela peut nous indiquer si la simplification a été trop un peu trop raide ou bien, le cas échéant, qu’elles en sont ses limites.

Internet et désinformation : une fake news ?

Internet est-il un vecteur puissant de désinformation ? Une vision très souvent partagée à ce sujet, notamment dans le milieu de la zététique (je l’avoue, je l’ai moi-même déjà fait) suggère le mécanisme suivant : 1/ internet est un marché de l’information dérégulé, c’est-à-dire que n’importe qui peut écrire et diffuser quasiment n’importe quoi sur internet ; 2/ cette dérégulation se couple à la propention naturelle des individus à tomber dans des pièges de la pensée (biais cognitifs et biais de raisonnement) ; 3/ ce couplage explique pourquoi tant de gens croient tant de choses fausses et les partagent massivement. On se propose dans cet article de regarder dans quelle mesure ce constat et l’explication convoquée sont soutenus par la littérature scientifique sur ce sujet. Deux aspects sont abordés conjointement. Premièrement, l’ampleur du phénomène : à quel point adhérons-nous à notre époque à des croyances non épistémiquement garanties ? À quel point partageons-nous, sur les réseaux sociaux, des « fakenews » et des narratifs dits « complotistes » ? Deuxièmement, le rôle spécifique d’internet dans ce phénomène : un tel marché de l’information dérégulé conduit-il, ou participe-t-il activement, à une diffusion et une adhésion accrues à ces thèses ? (Edit après reception de la première version de cet article.21)

N’y allons pas par quatre chemins : le constat alarmant d’un partage et d’une adhésion massive à des croyances fausses sur internet et son rôle actif dans ce processus est loin de faire consensus parmi les spécialistes du sujet. Même si la première étude s’intéressant au lien entre fakenews et nouveaux outils de communication remonte à 1925 22, c’est surtout avec le développement d’internet, et donc ces toutes dernières années, que la littérature scientifique sur le sujet s’est considérablement accrue. Pour autant, elle reste naissante, et aucun constat définif ne peut être tiré. Ceci est déjà un premier argument contre l’élan catastrophiste qui peut caractériser parfois certains discours sur internet et les fakenews. Mais de plus, on peut observer que rien ne semble aller dans ce sens. Au contraire même, la tendance générale qui se dégage de ces études est que la diffusion et le partage de fakenews est un phénomène extrêmement marginal. Par exemple, deux études ont porté sur la diffusion et le partage de fakenews pendant l’élection présidentielle de 2016, sur twitter 23 et facebook 24 respectivement. La première montre notamment que 1 % des comptes étudiés représentent à eux seuls 80 % des fakenews diffusées, et 0,1 % des comptes représentent 80 % des fakenews partagées. La seconde est du même acabit : le partage d’articles provenant de domaines identifiés comme produisant des fakenews est un phénomène rare : il touche environ 10 % à peine des comptes présent dans le panel de l’étude (les autres 90 % n’ont partagé aucun lien de ce type durant l’élection présidentielle.) Ce phénomène semble donc être assez marginal, au point que d’autres auteurs se sont même demandé « pourquoi si peu de gens partagent des fakenews ? » 25 Dans cet article, ils reviennent justement sur ce constat émergeant et assez contre-intuitif dans une période historique qui est sensée être celle de la « post-vérité », et tentent d’y apporter une explication.

Un second type de questions à se poser pour mesurer l’ampleur du phénomène est la relation entre le fait d’être exposé à des fakenews et le fait d’y croire. Si beaucoup de gens sont exposés à des fakenews (ce qui n’est déjà pas le cas), vont-ils pour autant y croire ? Et si c’est le cas, comment être sûr que ce n’est pas justement parcequ’ils y croient déjà qu’ils vont avoir tendance à s’y exposer selectivement ? Comme on le dit souvent, corrélation n’est pas causalité ! On reviendra sur cet argument plus loin, au sujet des théories du complot. Mais avant, une autre relation est à questionner : celle qui pourrait exister entre le fait de partager des fakenews et le fait d’y croire. Ici, cela semble a priori plus évident : si on partage une fakenews, c’est qu’on y croit forcément. De nouveau, les résultats des quelques études qui existent sur le sujet sont assez contre-intuitifs. Cette étude26 réfute la thèse selon laquelle les personnes partagent des fakenews car elles ne sont pas capables de faire la distinction avec une vraie information. Selon cette étude, c’est la polarisation politique qui joue un grand rôle dans le partage de fakenews, c’est-à-dire que l’on va partager principalement des informations qui confirment nos prédispositions politiques, sans forcément vérifier la véracité de ce que l’on partage – mais tout en étant capable de le faire. Celle-ci27 montre également que bien qu’elles partagent des fakenews, les personnes interrogées sont capables de différencier entre une vraie et une fausse information (en tout cas dans une proportion plus grande que ce qu’elles partagent.) Cette étude suggère que c’est principalement parce que le contexte des réseaux sociaux focalisent leur attention sur d’autres facteurs que la véracité, comme par exemple le fait de plaire aux yeux de ses suiveurs/amis sur ces mêmes réseaux, qui fait que des personnes partagent des fakenews. D’ailleurs, en primant les personnes à propos de l’attention avant qu’elles ne partagent quoique ce soit, ils observent en effet une diminution du partage de fakenews. Cette dernière étude28 a cherché à mettre en évidence la caractéristique que les fakenews devaient posséder pour être plus partagées. Elle a mis en évidence que le facteur « interestingness-if-true » était prépondérant, c’est-à-dire que les fakenews qui sont le plus partagées sont celles qui seraient vraiment intéressantes/pertinentes si elles étaient vraies. Pour approfondir ces questions, je ne peux que vous conseiller le visionnage de la conférence d’Hugo Mercier, l’un des auteurs de certains papiers sus-cités, intitulée: « Les fakenews doivent-elles nous inquiéter ? »

Parlons maintenant de ce qu’on appelle les « théories du complot ». On peut les définir29 comme la croyance que certains phénomènes sociaux et évènements politiques (voire une grande majorité d’entre eux) peuvent être expliqués par l’action concertée d’un petit nombre d’individus qui se réunissent en secret en vue d’orienter la marche du monde dans leur intérêt personnel. Nous ne reviendrons pas sur la façon de déconstruire certains narratifs complotistes, déjà exposée dans plusieurs articles sur ce site, en particulier ici. Les théories du complot représentent elles aussi un phénomène largement étudié dans la littérature spécialisée. Des enquêtes régulières montrent qu’une partie non négligeable de la population française croit à une ou plusieurs théories du complot. Ce n’est donc sûrement pas un phénomène marginal. Cependant, la question que l’on va se poser ici est la suivante : quel est le rôle d’internet, et plus spécifiquement des réseaux sociaux, dans la diffusion et la croyance dans les théories du complot ? L’article de Joseph E. Uscinski, Darin DeWitt et Matthew D. Atkinson intitulé « A web of conspiracy ? Internet and conspiracy theory »30 explore spécifiquement l’effet d’internet sur la diffusion et l’adhésion à des narratifs conspirationistes. Encore une fois, les preuves empiriques manquent pour soutenir l’idée qu’internet favorise ce phénomène. Trois points sont importants à retenir de cet article : 1/ les narratifs complotistes ont toujours existé et rien ne permet d’affirmer qu’internet, malgré le fait que l’information y circule beaucoup plus vite qu’avant, ait engendré une quelconque « nouvelle ère » du conspirationnisme ; 2/ les individus ne sont pas si malléables que cela et c’est principalement leurs dispositions a priori qui va les pousser à croire à telle ou telle chose, et non pas l’outil particulier qu’ils utilisent ; 3/ les sites conspirationnistes sont loin d’être les sites les plus fréquentés, et être exposé à une information ne signifie pas y croire – ce qui rejoint un constat déjà énoncé plus haut. Un article récent31 confirme ces tendances. Dans cet article, ils partent du constat que l’adhésion à des narratifs complotistes est fortement corrélé à l’usage des réseaux sociaux. Ce qu’ils explorent dans cette étude, c’est le lien de causalité sous-jacent : est-ce que c’est le fait d’utiliser beaucoup les réseaux sociaux qui rend complotiste, ou bien le fait d’avoir déjà des prédispositions à adhérer à ces formes d’explications qui pousse à aller voir et diffuser du complotisme sur internet ? Leur conclusion penche clairement pour la deuxième option, une fois controlés les potentiels facteurs confondants : « La relation conditionnelle que nous dévoilons suggère que l’impact des réseaux sociaux sur les croyances aux théories du complot et à la mésinformation est probablement négligeable, sauf sur les individus attirés ou autrement prédisposés à accepter de telles idées. »32

On pourrait reprocher au présent article de reposer sur du cherry-picking, c’est-à-dire de ne choisir que des études qui vont dans le sens de notre propos. C’est vrai qu’on ne peut clairement pas déduire un constat général et immuable à partir d’un petit nombre d’études. Si on s’est appuyé sur ces études, c’est pour deux raisons principales : 1/ voir comment de telles hypothèses peuvent être effectivement testées, ce qui est intéressant du point de vue méthodologique ; 2/ l’introduction de ces articles consiste souvent en un bon résumé de l’état de l’art sur la question, d’où le fait qu’on se soit appuyé sur des publications assez récentes. Il faut toutefois garder à l’esprit que les résultats de ces études sont conditionnés par la définition de « fakenews » adoptée. Dans nombre de ces études, par exemple, on mesure l’exposition à des fakenews en identifiant certains sites comme sources de fakenews et en comptant le nombre d’articles provenant de ces sites qui sont ensuite partagés sur les réseaux sociaux. Évidemment, ce ne sont qu’une partie des fakenews auxquelles nous sommes exposé-e-s, et ceci constitue une limite de ce type d’études. Mais dans tous les cas, cela montre aussi, comme on l’a déjà remarqué, que la thèse contraire – celle que l’on critique ici – n’a pas de raisons d’être affirmée avec autant d’assurance, en cela même que le phénomène que l’on souhaite étudier est, justement, technique et difficile à cerner.

Une dernière remarque s’impose sur le premier postulat de la thèse que l’on met à l’épreuve ici : le caractère « dérégulé » d’internet vu comme un marché de l’information. Ce que l’on entend par là habituellement, c’est que « tout le monde peut écrire et diffuser tout et n’importe quoi sur internet », sous-entendu sans la vérification rigoureuse que l’on pourrait attendre des médias et des journalistes professionnels. Ce que l’on peut sous-entendre aussi, c’est l’idée que le monde d’internet serait en quelque sorte déconnecté du monde « extérieur » des médias traditionnels, et que toutes les informations diffusées en ligne pourraient se retrouver sur un pied d’égalité en terme d’exposition. C’est une idée à balayer très vite. Dans sa conférence intitulée « Les infox et les nouveaux circuits de l’information numérique »33 le sociologue Dominique Cardon montre, entre autres choses extrêmement intéressantes pour notre propos, que la libéralisation du marché de l’information en ligne n’implique aucunement que ce dernier s’horizontalise d’une quelconque manière. Au contraire, il se trouve qu’il est fortement structuré et reproduit la hiérarchie déjà présente hors ligne. Plus précisément, lorsque l’on étudie l’architecture des citations entre les différents sites internet de médias via les liens hypertextes, on se rend compte que les sites des médias mainstream, c’est-à-dire ceux qui sont déjà en situation de domination du marché hors internet, restent de loin les sites qui se citent le plus entre eux et qui sont cités par les plus « petits » sites, alors que l’inverse n’est pas vrai. Cela signifie que la structure du marché de l’information, même si fondamentalement « tout le monde peut écrire ce qu’il veut sur internet », se modèle sur celle qui existe hors internet. Le fait qu’une information, même complètement aberrante, soit présente en ligne ne signifie pas qu’elle est vue et encore moins crue par beaucoup de personnes. Une synthèse de la littérature au sujet de la mésinformation en ligne34 va plus loin et tente de quantifier le rôle des médias mainstream dans la diffusion des fakenews. Ils partent d’une situation paradoxale dans laquelle se retrouvent ces médias : lorsqu’ils parlent des fakenews, ne serait-ce que pour les démentir, ils participent aussi à leur diffusion. Le résultat de cette étude est clair : les médias mainstream font partie du problème, dans le sens où il s’avère que ce sont eux qui sont les principales sources de diffusion de fakenews, bien devant les réseaux sociaux et sites conspirationnistes obscures. Ce résultat se comprend d’autant mieux en ayant en tête les résultats présentés par Dominique Cardon dans sa conférence sus-citée : les médias mainstream, sur internet ou ailleurs, restent – et de très loin – les médias les plus visibles. En partageant et en répétant des fakenews, même pour les démentir, ces médias les rendent probablement beaucoup plus visibles que si leur diffusion restait confinée à internet. Ils prennent également le risque que le « démenti » soit oublié et qu’à force de répétition, les personnes exposées à ces fakenews puissent finir par y croire. C’est bien entendu aussi quelque chose qu’il faut garder à l’esprit si l’on vulgarise du contenu sceptique, basé notamment sur du « débunkage », sur internet ou ailleurs.

De ces différents constats, il est clair qu’une tendance émerge : internet, en tant que « marché dérégulé de l’information » n’a pas l’air d’avoir d’impact spécifique (c’est-à-dire en lui-même) sur l’adhésion à des thèses conspirationnistes, ni sur la diffusion, le partage ou l’adhésion à des fakenews. La littérature spécialisée sur le sujet des théories du complot émet pourtant des hypothèses assez bien consensuelles sur des facteurs qui pourraient jouer sur l’adhésion, à l’échelle d’une population, à des narratifs conspirationnistes. Les premiers chapitre de la thèse d’Anthony Lantian35 ainsi que le chapitre « Sociologie, théorie sociale et théorie de la conspiration » de Türkay Salim Nefes & Alejandro Romero-Reche, dans le récent Routledge handbook of conspiracy theories (2020) reviennent sur ces aspects et précisent que l’adhésion aux théories du complot tend à augmenter lorsque la confiance dans les autorités epistémiques officielles diminue, ainsi que dans des contextes d’incertitude ou de tragédies, et seraient prépondérante dans des groupes sociaux se percevant comme exclus du pouvoir politique.

La conclusion de ces différents constats n’est pas qu’il est inutile d’enseigner comment fonctionne le cerveau, quels sont les pièges cognitifs à l’oeuvre, ou encore transmettre des outils pratiques pour dégager le vrai du faux sur internet, bien entendu. L’éducation aux médias et à l’information reste une nécessité. Il faut simplement remarquer qu’en mettant en exergue le narratif, soutenu de plus par aucune preuve empirique, que c’est principalement la dérégulation d’internet alliée à nos biais cognitifs qui produit une adhésion massive à des théories du complot ou à des fakenews, on met complètement de coté les aspects purement politiques de la question : pourquoi a-t-on moins confiance dans les autorités ? Cette confiance est-elle due, ou bien doit-elle se mériter ? Quel est l’impact et donc la responsabilité des médias de masse dans le maintien du lien entre décideurs, scientifiques et population ? Éluder ces questions fondamentales ne relève pas uniquement d’une certaine malhonnêteté intellectuelle (surtout lorsqu’on prétend combattre la désinformation!) mais nous condamne immanquablement à ne jamais combattre proprement le problème.

La charge de la preuve sous l’angle bayésien

Un ami du cortecs, Antonin, en dernière année de licence de philosophie et avec un bon nombre d’années de réflexions critiques derrière lui, nous propose cette petite discussion autour du concept de charge de la preuve. Une occasion de s’inscrire dans la continuité de l’éclaircissement par l’approche bayésienne des outils pédagogiques de la zététique.

La charge de la preuve est un argument couramment utilisé par les sceptiques. Lors d’un débat, c’est à la partie qui porte la charge de la preuve d’amener des preuves de ce qu’elle affirme, et si elle ne le fait pas, il n’y a pas de raisons d’accepter ses affirmations. Il est souvent utilisé face à des défenseurs de médecines alternatives, de scénarios complotistes ou autres croyances ésotériques. Mais il n’est pas toujours évident de déterminer de manière rigoureuse qui doit porter la charge de la preuve, et d’expliciter les critères qui permettent d’assigner cette charge. Je me propose ici d’apporter quelques clarifications, en m’aidant de l’approche bayésienne.

L’argument de la charge de la preuve est souvent exprimé sous cette forme “c’est à la personne qui affirme quelque chose de prouver ce qu’elle affirme”, ou encore “ce qui est affirmé sans preuve peut être rejeté sans preuve”. Mais il importe de clarifier ce que l’on entend par “affirmer”, et ce que signifie le rejet d’une affirmation.

Prenons un exemple : je me promène en forêt avec un ami lorsque nous tombons sur un champignon. J’affirme « ce champignon est comestible », ce à quoi mon ami me répond : « je suis prêt à te croire si tu me le prouves, mais tant que tu ne me l’as pas prouvé, je n’accepte pas ton affirmation. Je considère donc a priori que ce champignon n’est pas comestible. » Cela semble sensé, si l’on considère que la négation de l’affirmation est la position par défaut. Mais c’est en réalité un écueil à éviter.

Car si j’avais au contraire affirmé en apercevant ce champignon « Il est vénéneux », en suivant les mêmes principes, mon ami aurait dû avoir comme position a priori la négation de cette affirmation, « ce champignon n’est pas vénéneux », à savoir « ce champignon est comestible », soit la négation de la proposition a priori du premier cas ! Le fait que j’affirme en premier que ce champignon soit comestible ou vénéneux semble contingent et arbitraire ; cela ne peut pas déterminer une position rationnelle a priori sur la toxicité du champignon.

On voit ici que la notion de ce qu’est une affirmation ou une négation semble floue : je peux affirmer qu’un champignon est vénéneux : d’un point de vue logique, cela est strictement équivalent à affirmer qu’il est pas comestible, c’est-à-dire à nier qu’un champignon est comestible. Nous nous sommes fait piéger ici par la grammaire de notre langage. Cela est très fréquent et a incité les philosophes à essayer de construire un langage purement logique. Mais la syntaxe et la grammaire de nos langues façonnent tellement notre manière de penser qu’il est extrêmement difficile de voir à travers elles pour déceler la structure logique réelle de nos idées. Retenons simplement que l’affirmation logique n’est pas liée à la forme grammaticale de l’affirmation. Une affirmation, dans le sens qui nous intéresse ici, c’est le fait de défendre une position, même si cette position consiste à nier grammaticalement une proposition.

Il faut donc bien garder en tête que “rejeter une affirmation” qui n’est pas soutenue par des preuves, ce n’est pas “accepter la négation de cette affirmation” : c’est simplement suspendre son jugement. Que l’on fasse une affirmation positive ou négative, on porte la charge de la preuve.

Mais lors d’un débat, on a bien souvent deux opinions contraires qui s’opposent. Lorsque quelqu’un m’affirme que le crop circle qui est apparu dans la nuit est d’origine extra-terrestre, je ne me contente pas de rejeter son affirmation et de suspendre mon jugement, je fais une affirmation à mon tour en disant que ce crop circle n’a PAS été réalisé par des extra-terrestres. Qui porte la charge de la preuve dans ce cas ?

Examinons plusieurs catégories d’affirmations.

Premièrement, celles qui touchent directement à des questions scientifiques.

A l’échelle du débat scientifique dans sa généralité, la partie qui porte la charge de la preuve est celle qui vient contredire le résultat scientifique le plus solide dont on dispose. La charge de la preuve a déjà été remplie par ce résultat scientifique même, qui porte en lui sa justification. Cela peut-être une étude isolée qui n’a pas été répliquée, qui ne présente donc qu’un faible degré de confiance, mais si c’est la seule étude dont on dispose sur un sujet donné, elle a rempli son devoir de la charge de la preuve. La charge de la preuve réside donc sur la partie qui viendrait contredire ce résultat. Elle devra fournir au moins une étude de portée au moins équivalente pour remettre en cause l’affirmation du statu-quo, ou bien mettre en évidence le manque de fiabilité de l’étude précédente. Si elle présente une étude statistiquement plus fiable, ou une méta-analyse, ce sont ces nouveaux résultats qui contredisent les précédents qui deviennent le statu-quo scientifique, et la charge de la preuve revient maintenant à qui veut remettre en cause ce nouveau statu-quo, (cela peut être en produisant une méta-analyse plus impactante, en prouvant que les données sur lesquelles s’appuie la méta-analyse sont mauvaises, ou que les scientifiques qui l’ont produite sont corrompus…) et ainsi de suite.

Lors d’un débat entre deux individus sur une question scientifique, il suffit donc d’introduire l’état de l’art du débat scientifique dans le débat personnel pour porter la charge de la preuve qui soutient le statu-quo scientifique. Encore faut-il apporter la preuve, en fournissant les sources, que l’avis scientifique se range bien de son côté.

Mais souvent, le débat porte sur des questions qui n’ont pas encore traitées directement par la science, soit qui sortent du cadre de la science, soit qui n’ont pas encore été tranchées. Qui doit donc commencer par porter la charge de la preuve dans ce cas ?

Cela nous amène à une deuxième catégorie, celles qui affirment l’existence d’une entité, métaphysique ou non.

Par exemple, Dieu. On observe souvent une utilisation fallacieuse de la charge de la preuve dans ce débat. L’existence de Dieu est affirmée par une des parties, et fait porter la charge de la preuve à la partie adverse pour réfuter son existence. Si la partie adverse ne le peut pas, la première partie en conclut donc que Dieu existe.

Un argument pour répondre à cela est celui de la théière de Russell. Il reprend la structure de l’argument, mais en remplaçant Dieu par une petite théière en orbite dans le système solaire, indétectable par les télescopes. Puisqu’il n’est pas possible de prouver la non-existence de cette théière, si on suit le même raisonnement, alors on doit conclure qu’elle existe. Pourtant, peu de personnes seraient prêtes à accepter la conclusion de cet argument, qui semble absurde, et il faut donc rejeter la validité de l’inférence. Ce que cherche à illustrer cette théière cosmique, c’est que l’irréfutabilité de l’existence d’une entité, quelle quelle soit, ne permet pas d’affirmer l’existence de cette entité.

Mais si la charge de la preuve ne repose pas sur la partie qui nie l’existence de Dieu, repose-t-elle pour autant sur celle qui l’affirme ? On l’a vu, affirmer ou nier l’affirmation sont tous deux des affirmations. Et pourtant, dans ce cas, la charge de la preuve repose bien sur la personne qui affirme l’existence de Dieu. C’est le fameux rasoir d’Occam qui permet de justifier cela, qui dit qu’il faut préférer les hypothèses les moins “ontologiquement coûteuse”, c’est-à-dire les hypothèses qui mobilisent le moins d’entité possible pour expliquer un phénomène. Affirmer l’existence d’une entité à un coût qui doit se justifier : ce coût est la charge de la preuve.

Pour assumer la charge de la preuve d’une hypothèse ontologiquement plus coûteuse qu’une autre, il faut montrer qu’elle permet de rendre compte de certains phénomènes qui ne peuvent pas être expliqué avec les hypothèses plus parcimonieuses.

Il y a ensuite une 3ème catégorie, les questions qui touchent à des cas qui n’ont pas été traités directement par la science.

Par exemple, lorsque quelqu’un affirme : “ce crop circle a été fait par des aliens”, je ne me contente pas de rejeter cette affirmation, et de suspendre mon jugement. Je vais affirmer que ce crop circle n’a PAS été réalisé par des aliens, même si je n’ai aucune information sur ce crop circle précis. A l’aide d’un calcul bayésien, basé sur des données antécédentes à ce crop circle particulier, il semble peu probable que le CC soit fait par des aliens.

Voyons en détail : pour la théorie T : “les extra-terrestres ont fait ce CC”, la donnée D « un CC est apparu pendant la nuit”, on a la probabilité que « la théorie T soit vrai en sachant la donnée D » égale à P(D|T)xP(T) / P(D). P(D) peut s’exprimer sous la forme P(D|T)P(T) + P(D|A)P(A) ou A est l’ensemble des théories alternatives qui expliqueraient D (principalement, et pour la totalité des CC jusque ici, des humains blagueurs).

Il faut maintenant estimer subjectivement la valeur de ces probabilités. P(D|T)=1, puisqu’il est certain que si des aliens étaient venus faire un CC, nous observerions un CC. J’estime ensuite que la probabilité a priori de la visite des aliens est très faible, mais soyons charitable et admettons une probabilité de 0,5 (cette valeur influe peu sur le calcul de toute façon), j’estime P(D|A) à environ 0,95 puisqu’on a été capable d’expliquer la majorité des CC avec une explication autre que celle extra-terrestre (il est donc très probable d’observer un CC même si les aliens ne visitaient pas la terre), et P(A) très élevée (disons 0,999 puisqu’on observe tous les jours des humains blagueurs).

Le résultat du calcul nous donne une probabilité de 0,34 (inférieur à 0,5)

Je vais donc affirmer qu’il a une autre origine que celle extra-terrestre. Mon interlocuteur devra m’apporter des nouvelles données sur ce CC particulier de manière à modifier le résultat du calcul bayésien et faire pencher la probabilité du côté opposé (supérieur à 0,5), c’est-à-dire qu’il devra m’apporter des nouvelles données qui ont une probabilité très faible d’arriver dans le cadre d’une explication alternative, ou de me fournir des éléments qui amèneraient à penser que la probabilité a priori de la visite des extra-terrestres est proche de 1. S’il le fait, la charge de la preuve pèse maintenant sur mes épaule si je veux continuer à affirmer qu’il a une origine autre qu’extra-terrestre.

Cette approche bayésienne de la charge de la preuve permet de la faire porter aux personnes qui prétendent qu’une nouvelle médecine alternative fonctionne. Ces dernières fleurissent à un rythme bien supérieur à celui de la marche de la science, il est donc impossible de toute les réfuter scientifiquement. Mais même sans information précise sur une médecine alternative particulière, on peut quand même se permettre d’en nier l’efficacité et de faire porter la charge de la preuve à la personne qui affirme son efficacité. Du fait que ces déclarations du pouvoir guérisseur miraculeux de toutes sortes de choses pullulent autant, et que beaucoup ont quand même pu être réfutées, on sait que la probabilité qu’une personne affirme qu’une médecine alternative marche alors qu’elle ne marche pas est très élevée, ainsi que le probabilité a priori qu’elle ne marche pas. Du fait de ces hautes grandeurs dans le dénominateur de la formule de Bayes, la probabilité qu’une médecine marche en sachant qu’une personne affirme qu’elle marche est toujours inférieur à 0,5 a priori.

En conclusion, la charge de la preuve n’est pas une règle épistémologique absolue, elle reflète simplement la position du curseur de probabilité bayésien en fonction des nouvelles données qui s’ajoute au calcul. Mais ce calcul reste lié à des données subjectives a priori, antécédente au débat, et la position de ce curseur ne peut donc être une position objective. La charge de la preuve est un outil pratique dans le débat, mais il serait peut-être plus judicieux de le traduire en terme bayésien, et plutôt que de dire “tu portes la charge de la preuve”, dire “mon curseur bayésien attribue une faible probabilité à la croyance que tu défends. A toi de m’apporter des nouveaux éléments susceptible de faire pencher ce curseur de l’autre côté.”

À propos du critère de réfutabilité et des hypothèses ad hoc

Le critère de réfutabilité est bien connu dans le milieu zététique : élément clé permettant de distinguer sciences et pseudosciences, il est pourtant plus difficile à manier qu’il n’y paraît. Afin d’éviter que le corps astral de Karl Popper ne se retourne dans son plan cosmique sépulcral, notre collègue Jérémy Attard nous aide à nous y retrouver, rappelant les bases de ce concept majeur d’épistémologie, puis en pointant les écueils à contourner lorsqu’il est question de le vulgariser.

[toc]

Simplifier, sans déformer

Dans notre enseignement de la zététique nous avons souvent coutume de déclarer : « Une proposition irréfutable n’est pas scientifique ! » ce qui pourrait sous-entendre qu’une telle proposition ne mérite pas notre attention. Nous entendons par « proposition irréfutable » indistinctement les propositions du type « demain il va pleuvoir ou bien il ne va pas pleuvoir » comme celles du genre « oui, certes, on a des photos de la Terre vue de l’espace, mais c’est des montages de la NASA pour nous cacher que la Terre est plate ! » Le premier cas correspond à une proposition vraie indépendamment de l’expérience et donc qui n’a pas beaucoup de chance de nous apporter une quelconque information substantielle sur le monde ; le second est un cas bien connu d’immunisation contre la réfutation consistant à rajouter une hypothèse ad hoc pour sauver une thèse à laquelle on tient. Lorsque nous parlons de ce critère de réfutabilité, nous faisons évidemment référence à l’éminent philosophe des sciences Karl Popper qui l’a établi et popularisé dans les années 1930 [1]. Cependant, de même qu’il ne viendrait à l’idée de personne, a priori, de présenter l’effet placebo tel que décrit dans la première méta-analyse de Henry Beecher en 1955 sans tenir compte des travaux plus récents qui le remettent assez profondément en question, il nous semble étrange de résumer l’épistémologie, et notamment la réfutabilité, à Karl Popper sans prendre en compte ce qu’il s’est passé après lui. Il ne s’agit pas, dans un enseignement de zététique consacré aux bases épistémologiques, de faire un cours à proprement parler d’épistémologie, bien entendu. Il s’agit simplement de glisser quelques nuances, qui apporteront un peu de profondeur au problème sans pour autant nous perdre dans des considérations stratosphérico-métaphysiques désincarnées des besoins d’outils pratiques de celles et ceux venu-e-s nous écouter.

Photo et citation de Karl Popper

Il s’agit, d’abord, de réaliser une meilleure vulgarisation que celle que nous faisons. Dans toute démarche de vulgarisation, il y a un équilibre subtil à trouver entre la simplicité du propos, dans un but pédagogique de transmission, et sa solidité scientifique. Ce que l’on gagne en simplicité, on le perd très souvent en rigueur et inversement. Ce que nous proposons ici est une façon de présenter le critère de réfutabilité qui améliore cet équilibre par rapport à la façon dont il est habituellement enseigné. N’oublions pas que comprendre le critère de réfutabilité est un objectif pédagogique avant tout : donner un outil simple d’utilisation pour identifier rapidement, au moins dans un premier temps, ce qui distingue une science d’une pseudoscience. Mais une trop grande simplification, pour toute pédagogique qu’elle soit, peut se retourner contre son but initial si l’on ne transmet pas en même temps l’idée que « c’est un peu plus compliqué que ça » ainsi que des pistes pour aller chercher plus loin.

En effet, si l’on creuse un peu l’histoire des sciences d’une part, et la philosophie des sciences d’autre part, on se rend rapidement compte de deux choses : 1/ les théories les plus scientifiques sont fondées sur des propositions irréfutables ; 2/ le fait d’ajouter des hypothèses pour « sauver » une théorie constitue la majeure partie du travail des scientifiques. Une fois ces deux faits établis, et donc mis à jour le caractère un peu « léger » de notre critique usuelle de l’irréfutabilité, nous verrons comment l’améliorer sans trop d’efforts et ainsi ne plus tendre l’homme de paille36 pour nous faire battre. En effet, une personne défendant un contenu pseudoscientifique et un tant soit peu au fait de l’histoire ou de la philosophie des sciences pourrait nous rétorquer que la science, telle qu’on la présente, fonctionne en réalité de la même manière (et elle n’aurait pas tort…) C’est aussi l’occasion de donner quelques références supplémentaires en épistémologie si l’on veut aller creuser le sujet.

La théorie peut-elle réfuter l’expérience ?

C’est un fait bien accepté qu’une théorie scientifique doit pouvoir rentrer en contradiction avec l’expérience. Le raisonnement est relativement simple : une théorie scientifique prétend dire quelque chose de non trivial sur le monde, et donc tirer sa validité de l’expérience. Si une théorie est irréfutable, c’est-à-dire si elle ne produit que des énoncés tautologiques, vrais en dehors de toute expérience, sa validité ne va pas être conditionnée par celle-ci. L’expérience est pourtant in fine la seule manière que l’on a de rentrer en contact avec la réalité objective dont on prétend pouvoir obtenir une information fiable. Une théorie qui ne produit que des énoncés tautologiques ou qui est immunisée d’une manière ou d’une autre contre la réfutation ne pourra donc pas obtenir d’information non triviale sur le monde, et ainsi ne pourra pas être considérée comme scientifique. En d’autres termes, ce qui est intéressant lorsque l’on prétend dire quelque chose sur le monde, ce n’est pas simplement d’avoir raison, mais d’avoir raison alors qu’on aurait très bien pu avoir tort : c’est de ce type de validation qu’une théorie tire sa valeur scientifique.

Il faut donc que la théorie ait une possibilité de rentrer en contradiction avec l’expérience. Mais, plus précisément, qu’est-ce qui rentre en contact avec l’expérience, dans une théorie ? Prenons un exemple concret, tiré de la physique : le principe de conservation de l’énergie. Dans le cadre de la physique newtonienne, celui-ci s’énonce de la manière suivante : « L’énergie totale d’un système isolé se conserve », un système isolé étant défini comme un système qui n’échange ni énergie ni matière avec l’extérieur. En gros, l’énergie peut changer de forme au sein du système mais ne peut pas disparaître ou apparaître si le système est isolé. Posons-nous alors la question : est-ce que ce principe est réfutable par l’expérience ? On a envie de dire oui, à première vue : si l’on observe un système qu’on a de bonnes raisons de considérer comme isolé et dont l’énergie totale augmente ou diminue, alors on pourrait dire que l’on a réfuté ce principe. Pourtant, penser de cette façon est une erreur à la fois au regard de l’histoire que de la philosophie des sciences. En effet, historiquement, à chaque fois que ce principe a été remis en question, on ne l’a jamais abandonné : on l’a au contraire considéré comme vrai a priori, ce qui a poussé les physicien-ne-s à inventer de nouvelles entités ou des nouveaux phénomènes (par exemple, des formes d’énergies ou des particules inconnues jusqu’alors) pour « sauver » ce principe contre l’expérience : la théorie peut en quelque chose parfois réfuter l’expérience37.

Et cette méthode a très souvent porté ses fruits puisqu’elle a conduit à la découverte de Neptune, des forces de frottements, des neutrinos ou encore du boson de Higgs : dans chacun de ces cas précis, face à une réfutation par l’expérience, on a imaginé des hypothèses pour expliquer pourquoi l’expérience ne collait pas avec ce que l’on avait prédit, tout simplement parce que la solidité de la théorie était posée comme une certitude acquise au vu de ses nombreux succès expérimentaux précédents. On trouvera de nombreux exemples de cette façon de fonctionner en particulier dans les travaux de Thomas Kuhn. Celui-ci, dans son ouvrage majeur [2], décrit en effet l’activité « normale » du ou de la scientifique comme étant la résolution de problèmes au sein d’un paradigme donné. Les « problèmes » dont il s’agit ne sont donc absolument pas considérés, de ce point de vue, comme des réfutations de la théorie dans son ensemble, mais simplement comme des anomalies qu’une reconfiguration de la théorie doit pouvoir absorber. Les anomalies fondamentales, comme celle de l’avancée du périhélie de Mercure, ne sont considérées comme telles que rétrospectivement, et peuvent très bien être parfaitement connues de la communauté scientifique pendant des décennies sans que cela n’implique la remise en question profonde de la théorie sous-jacente.

Du point de vue philosophique, maintenant, cela n’a pas vraiment de sens de considérer qu’un principe fondamental comme celui de la conservation de l’énergie puisse être vrai ou faux : en effet, si face à une contradiction avec l’expérience, on déclare que ce principe est faux, on ne peut plus rien faire ; on n’a pas réglé le problème, on est juste sorti du cadre au sein duquel c’était un problème – ce qui n’est pas du tout la même chose. Par exemple, le problème de l’accélération de l’expansion de l’univers, en cosmologie, est fondamentalement un problème de conservation de l’énergie. Si l’on déclare qu’en fait l’énergie ne se conserve pas, que ce principe est faux, l’accélération de l’expansion n’est plus un problème – son aspect problématique n’existe qu’au sein d’un paradigme où l’énergie se conserve. L’ennui est qu’une fois considéré ce principe comme réfuté, on se retrouve démuni pour faire de nouvelles prédictions, puisque tout ce que l’on avait pour parler de ce pan de la réalité était justement le principe de conservation de l’énergie !

Les programmes de recherche

Ainsi, devant ce double constat, il est intéressant d’affiner ce critère de réfutabilité et d’emprunter à Imre Lakatos, philosophe hongrois et disciple de Karl Popper, la notion de programme de recherche [3]. Pour Lakatos, un programme de recherche est constitué d’une part d’un noyau dur formé de définitions, de principes, de propositions définissant un cadre avec lequel on va investiguer un pan du réel, et d’autre part d’une certaine quantité d’hypothèses auxiliaires desquelles on va déduire, à l’aide des règles du noyau dur, des prédictions qui pourront rentrer en contradiction avec l’expérience. Ce sont ces prédictions-là qui doivent être réfutables, et rien d’autre. Si une prédiction rentre en contradiction avec l’expérience, alors on va modifier des hypothèses auxiliaires afin de résoudre cette contradiction. Un programme de recherche génère alors une suite de théories où l’on passe de l’une à l’autre par un changement d’hypothèses auxiliaires. Le problème, bien sûr, est qu’il y a toujours beaucoup de façons de réajuster notre édifice théorique afin de faire coller une prédiction avec l’expérience38. Karl Popper en est d’ailleurs lui-même bien conscient. Comme l’écrit Lakatos :

« Popper (…) en convient : le problème est de pouvoir distinguer entre des ajustements qui sont scientifiques et d’autres qui sont pseudoscientifiques, entre des modifications rationnelles et des modifications irrationnelles de théorie. Selon Popper, sauver une théorie à l’aide d’hypothèses auxiliaires qui satisfont des conditions bien définies représente un progrès scientifique ; mais sauver une théorie à l’aide d’hypothèses auxiliaires qui n’y satisfont pas représente une dégénérescence. »39

La planète Vulcain : trajectoire calculée mais jamais observée…

Pour le falsificationnisme méthodologique dont se réclame Karl Popper, on a le droit de rajouter ou de modifier certaines hypothèses suite à une contradiction avec l’expérience si cette modification augmente le niveau de réfutabilité de la théorie, c’est-à-dire si cela nous pousse à faire de nouvelles prédictions indépendantes du fait de simplement résoudre la contradiction initiale. Si ces nouvelles prédictions, réfutables, sont validées, alors on a augmenté notre connaissance sur le monde, et c’était une bonne chose de « protéger » notre théorie de la réfutation par l’ajout d’hypothèses. L’exemple de la découverte de Neptune est parlant. Au début du dix-neuvième siècle, la planète du système solaire la plus lointaine alors connue était Uranus, et il s’est vite avéré que sa trajectoire semblait ne pas se soumettre à ce que la théorie de Newton prédisait. Plusieurs solutions s’offraient aux astronomes de l’époque, comme par exemple admettre que la théorie de Newton n’était plus valable à cette échelle. Cependant, la première explication qui fût considérée était qu’il existait une planète encore inconnue à l’époque, dont l’attraction gravitationnelle sur Uranus rendrait compte de sa trajectoire problématique. L’éminent astronome français Le Verrier40 calcula alors les caractéristiques de cette planète (en supposant qu’elle existait) à l’aide des lois de Newton, c’est-à-dire en les considérant comme valides. Neptune fut effectivement observée en 1846 à l’observatoire de Berlin, et ce qui aurait pu être une défaite de la théorie de Newton finit en réalité par en constituer une victoire de plus. Le programme de recherche, selon Lakatos, est alors dans sa phase progressive. Par contre, dès l’instant où la modification d’hypothèses ne permet pas de faire des prédictions réfutables mais simplement de résoudre la contradiction sans augmenter notre niveau de connaissance sur le monde, on se trouve alors dans une phase dégénérative, et la nécessité d’un nouveau programme de recherche, reposant sur un noyau dur différent, se fait sentir. La difficulté est évidemment qu’au pied du mur, on ne peut jamais savoir avec certitude si l’on est dans un cas où l’on peut encore modifier des hypothèses auxiliaires et augmenter notre connaissance ou bien si l’on est face à une aporie intrinsèque du programme de recherche. Ce n’est que rétrospectivement que la situation s’éclaircit. Dans la continuité de la découverte de Neptune, les astronomes de l’époque avaient aussi conjecturé l’existence d’une autre planète hypothétique, Vulcain, censée se trouvait entre le Soleil et Mercure et expliquait une anomalie, tout aussi bien connue, dans la trajectoire de cette dernière. Pour autant, cette planète ne sera jamais observée41. Il faudra attendre 1915 et la théorie de la relativité générale d’Einstein pour comprendre le mouvement apparemment inexplicable (dans le paradigme newtonien) de Mercure.

Willard Quine [4] parle aussi de ce phénomène – en allant toutefois encore plus loin dans sa critique. Il soutient la thèse du holisme de la confirmation, aussi connue sous le nom de thèse de Duhem-Quine : une proposition particulière ne fait pas face « toute seule » au tribunal de l’expérience, mais c’est l’ensemble de la théorie à laquelle elle appartient et in fine l’ensemble de notre savoir qui est testé lorsque l’on fait une expérience particulière. L’ensemble de notre savoir est un système conceptuel où il existe des connections fortes entre les différents domaines de recherche qui pourrait être pensés a priori comme indépendants. Il traduit donc autrement le fait déjà énoncé qu’il y a toujours plusieurs manières de modifier la toile d’araignée de nos connaissances pour ajuster une prédiction à l’expérience. Il énonce alors un principe de parcimonie : il est rationnel, parmi tous les ajustements possibles, de choisir en premier lieu celui qui modifie le moins de choses dans le reste de nos connaissances. Cela rejoint la métaphore de la grille de mots croisés de Susan Haack [5]. L’état d’ébriété d’un expérimentateur en neurosciences utilisant une IRM ou la fausseté de ses hypothèses seront toujours des explications plus parcimonieuses, face à une contradiction avec l’expérience, que la remise en question des lois de la mécanique quantique régissant le phénomène de résonance magnétique nucléaire sous-jacent au fonctionnement d’un dispositif d’IRM.

Irréfutabilité et méthode

Cette façon de voir les choses, pas beaucoup plus compliquée que la simple présentation du critère de réfutabilité, permet de résoudre le double problème rencontré plus haut. Les principes de bases d’une théorie sont ses règles de grammaire ; cela n’a aucun sens, ni logique, ni pratique, de penser qu’ils puissent être réfutés à l’intérieur de cette même théorie. Pour reprendre ce que dit Lakatos, cité plus haut, ce n’est pas tant une théorie qui est scientifique ou pseudoscientifique, mais plutôt la méthode avec laquelle on va la reconfigurer pour faire face à une réfutation. Plus précisément, face à une réfutation, on va modifier des hypothèses auxiliaires pour faire coller la théorie à l’expérience. La différence entre des astronomes découvrant Neptune et des platistes est alors double : 1/ face à une observation contradictoire, les astronomes « sauvent » une théorie qui est extrêmement bien corroborée par ailleurs, ce qui n’est pas le cas des platistes ; 2/ la reconfiguration de la théorie, dans le premier cas, satisfait à une exigence épistémologique contraignante de parcimonie et de prédictibilité, ce qui n’est pas le cas pour les platistes.

Comme on l’a dit, il reste indispensable, en zététique, de mettre en garde contre les propositions irréfutables en général. C’est un premier pas nécessaire, notamment pour mettre le doigt sur le fait que le propre de la science n’est pas de confirmer à tout prix ses prédictions mais d’échouer à les mettre en défaut – ce qui est impossible, ou trivial, plutôt, si l’on n’a affaire qu’à des propositions irréfutables. Pour autant, il ne semble pas non plus très coûteux de nuancer un peu ce propos, et de reconnaître que dire simplement d’une proposition isolée qu’elle est irréfutable et donc qu’elle n’est pas scientifique est un peu léger comme critique.

Lorsque la proposition en question est un principe de la théorie, sa valeur épistémique ne se juge pas par son aspect réfutable mais à l’aune de son potentiel heuristique, c’est-à-dire de sa capacité à nous faire découvrir de nouvelles entités ou des nouveaux phénomènes. Par exemple, le fait que le principe de refoulement au sein de la théorie psychanalytique soit irréfutable n’est pas un problème en soi ; le problème épistémologique de ce corpus théorique est que ses principes ne mènent à aucune prédiction validée qui aurait pu être réfutée.

S’il s’agit au contraire d’une prédiction dont la réfutation pourrait être résolue par l’ajout d’une hypothèse auxiliaire, la critique ne tient pas non plus : ce n’est pas le fait de sauver une proposition ou un noyau dur tout entier par l’ajout d’hypothèses qui est critiquable, c’est la manière avec laquelle cela est fait. Ainsi, face à toutes les observations terrestres et astronomiques que nous pouvons réaliser, on peut toujours les ajuster pour nous persuader que la Terre est plate. Cet ajustement, comme la plupart, est logiquement possible ; le problème est qu’il ne permet de faire aucune nouvelle prédiction, qu’il est hautement coûteux en hypothèses et qu’il ne tient pas face au modèle concurrent et éminemment plus parcimonieux de la Terre sphérique.

Les outils d’autodéfense intellectuelle issus de cette réflexion sont les mêmes qu’ailleurs : dans l’élaboration d’une connaissance synthétique et objective sur le monde, prédictibilité et parcimonie sont deux maîtres mots pour mener à bien cet art difficile.

Références

[1] K. Popper, La logique des découvertes scientifiques, Payot, 1973 (1934).

[2] T. Kuhn, La structure des révolutions scientifiques, Flammarion, 1972 (1962).

[3] I. Lakatos, A methodology of research programs, Cambridge, 1978.

[4] W.V. Quine, Les deux dogmes de l’empirisme, Harper, 1953

[5] Susan Haack, Le bras long du sens commun : en guise de théorie de la méthode scientifique, Philosophiques, vol. 30 , n°2, 2003, p. 295-320.

[6] W. V. Quine, On empirically equivalent Systems of the World, Erkenntnis, 3, 13–328, 1975.